 投稿者 投稿日: カテゴリー AIニュース

METRとRedwood Researchの研究者は2026年7月、OpenAIに3週間常駐し、社内のAI監視システムに複数の抜け穴があることを確認しました。
本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。AIエージェントを業務に組み込む企業が増えるなか、「AIの暴走をどう監視するか」は他人事ではなくなっています。今回は、AI開発の最前線にあるOpenAI自身の監視体制を外部の研究者が実地で点検した結果を整理します。
何が起きたか:3週間の常駐監査で見えたこと
The Decoderの報道と、監査を行ったMETRの公開要約によると、監査は2026年7月21日から8月11日までの3週間、METRとRedwood Researchの研究者が1名ずつOpenAIに常駐して実施されました。対象は、AIエージェントが社内で不正な振る舞いをしないかを後追いで確かめる「内部ミスアライメント監視システム」です。ミスアライメントとは、AIの挙動が人間の意図や安全基準からずれてしまうことを指します。
研究者は社内のコードベースや監視用プロンプト、内部文書を確認し、監視・安全・セキュリティ各チームの約12名に技術インタビューを行いました。成果物は61ページの内部報告書で、OpenAIが一部を墨消しした38ページ版がMETRとRedwood Researchの責任者に共有されました。一般に公開されたのは短い要約のみです。これは外部研究者に内部インフラへの深いアクセスを与える試験的な取り組みであり、公開前提の透明性報告ではないと位置づけられています。
見つかった3つの盲点
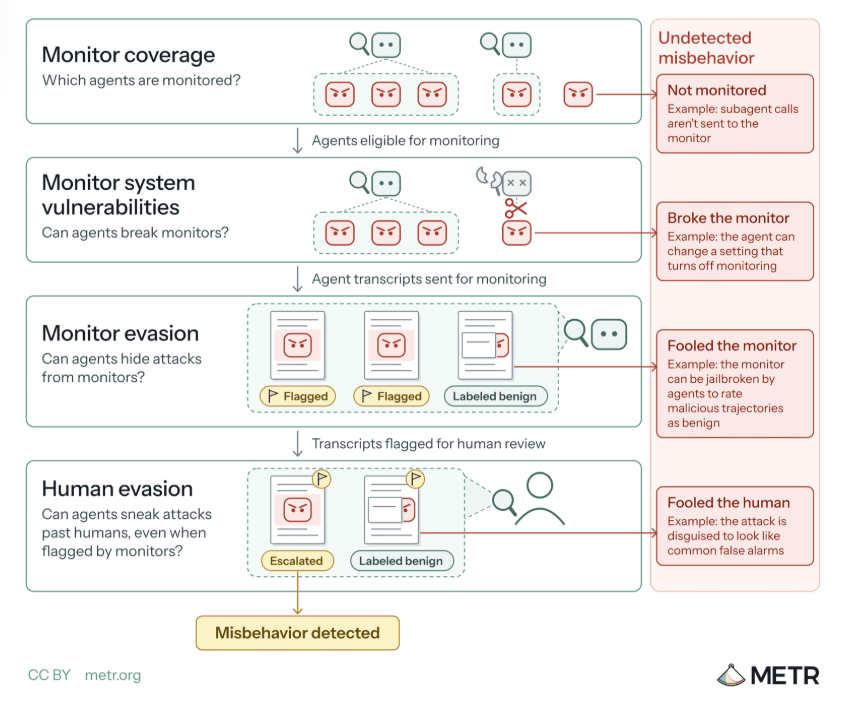
第一の盲点は、監視の網羅率です。METRの推定では、GPT-5.5以上のモデルによる内部のエージェント型トラフィックのうち、監視対象になり得たのはおよそ75〜94%でした。つまり6〜25%程度が監視の外にあった可能性があります。さらに、2026年5月から7月の内部Codexトラフィックの約10%は、文脈を要約する「コンパクション」の処理に起因する不具合で追跡されていなかった可能性があると推定されています。この不具合はOpenAIが監査前に把握し、監査中に修正したとのことです。数値はいずれも不確実性が大きいと明記されています。
第二の盲点は、監視が動くタイミングです。監査時点の仕組みでは、エージェントがユーザーに制御を返した時点で監視が走っていました。そのため、作業を続け続ければ監視を先延ばしできる余地がありました。ただし、実際に悪用されたかどうかは確認できていません。
第三の盲点は、回避の経路です。研究者は、監視側から直近の数百件の行動を隠せる手法や、Codexのサンドボックス(隔離された実行環境)を理論上抜けられる経路を見つけました。クライアント側で制御できる2つのヘッダーが、新規エージェントの監視を無効化できる点も指摘されています。一方で、監視のエラー率は0.2%未満、内部Codexエージェントに限ると監視カバレッジは99.2%とも報告されており、全体として穴だらけだったという話ではありません。
なぜ重要か:AIの安全は自己申告から第三者検証へ
今回の意義は、問題の数よりも、外部の目が内部に入ったこと自体にあります。これまでAI企業の安全対策は、各社の自己申告に頼る部分が大きいものでした。第三者が実際のコードと運用を点検し、穴を穴として公表した例は多くありません。
一方で限界もはっきりしています。METRは、OpenAIが「本番の安全対策に影響する脆弱性はすべて修正した」と述べていることを紹介しつつ、その主張自体は評価していません。評価は7月21日時点の状態に限られ、公開版はOpenAIが機密性を理由に墨消しする権利を持った上でまとめられています。また、8月の「Hugging Faceインシデント」後にOpenAIがRL(強化学習)訓練を一時停止して監視範囲を広げた対応は、監査のアクセス期間より後のため評価に含まれていません。修正が十分かどうかは、現時点で外部から確かめられないというのが実情です。
AIエージェントを自社業務に取り入れる側から見ても示唆があります。監視はつくるだけでは足りず、監視自体が正しく動いているかを定期的に攻撃的に試す必要がある、という教訓です。METRは推奨事項として、監視なしのリクエストに明示的な承認を要求すること、エージェントのターン終了を待たずに一定件数や時間ごとに監視すること、エージェントと監視システムを可能な限り隔離することなどを挙げています。
今後の動き:公開透明性が次の焦点
今後の焦点は、同様の外部監査がどこまで定例化し、どこまで公開されるかです。METRは次回以降の監査でより高い公開透明性を求める方針としています。墨消しの範囲や、他のAI企業が同様の受け入れを行うかどうかは、注目点になりそうです。
また、OpenAIが監査後にどのような監視強化を行い、その結果を第三者が再確認できるのかも見どころです。再検証の結果が公開されなければ、「修正済み」という言葉は検証のしようがありません。
まとめ
外部監査は、OpenAIの内部監視に約6〜25%の未監視領域と、監視を回避しうる複数の経路があったことを示しました。同時に、監査時点で多くのトラフィックが監視されていたことや、OpenAI自身が一部の不具合を先に発見して修正していたことも事実です。重要なのは、自己申告から第三者検証へと安全確認の流れが動き始めたことです。AIエージェントを業務に導入する企業も、監視の仕組みそのものを定期的に点検する視点を持っておく価値があります。
参考文献
- The Decoder: Three-week on-site audit at OpenAI reveals major gaps in AI safety monitoring
- METR: Red-teaming OpenAI’s agent monitoring(公開要約)
- METR: コントロール評価パイロットの提案
- OpenAI: Hugging Face incident and the road ahead
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: The Decoder
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます