 投稿者 投稿日: カテゴリー AIニュース

SemiAnalysisが公開した新ベンチマーク「GDPx」では、全11分野の総合で首位のClaude Opus 5.5でも12%にとどまりました。
本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。AIエージェントとは、人の指示を受けて複数の手順を自分で判断しながら実行するAIのことです。その実務力を測る新しい物差しが出てきたため、数字と注意点を整理します。
何が起きたか:206タスクで測る「仕事の完遂力」
The Decoderの報道によると、半導体・AI分野の調査会社SemiAnalysisは2026年11月5日(現地)前後に、新ベンチマークGDPxを公開しました。GDPxとは、AIエージェントをクイズではなく模擬の業務環境に置き、仕事をどこまで最後までやり切れるかを測る評価のことです。
タスク数は206件で、対象はチップ設計、生物学、クオンツ取引、サイバーセキュリティ、法務など11分野に及びます。1タスクは最長8時間かかり、Siemens NXのような専門ソフトの操作、数千ファイルのデータルームの検索、稼働中の企業システムへの攻撃といった作業が含まれます。行政と保険は意図的に対象外です。総合順位は11分野を同じ重みで平均して決まります。
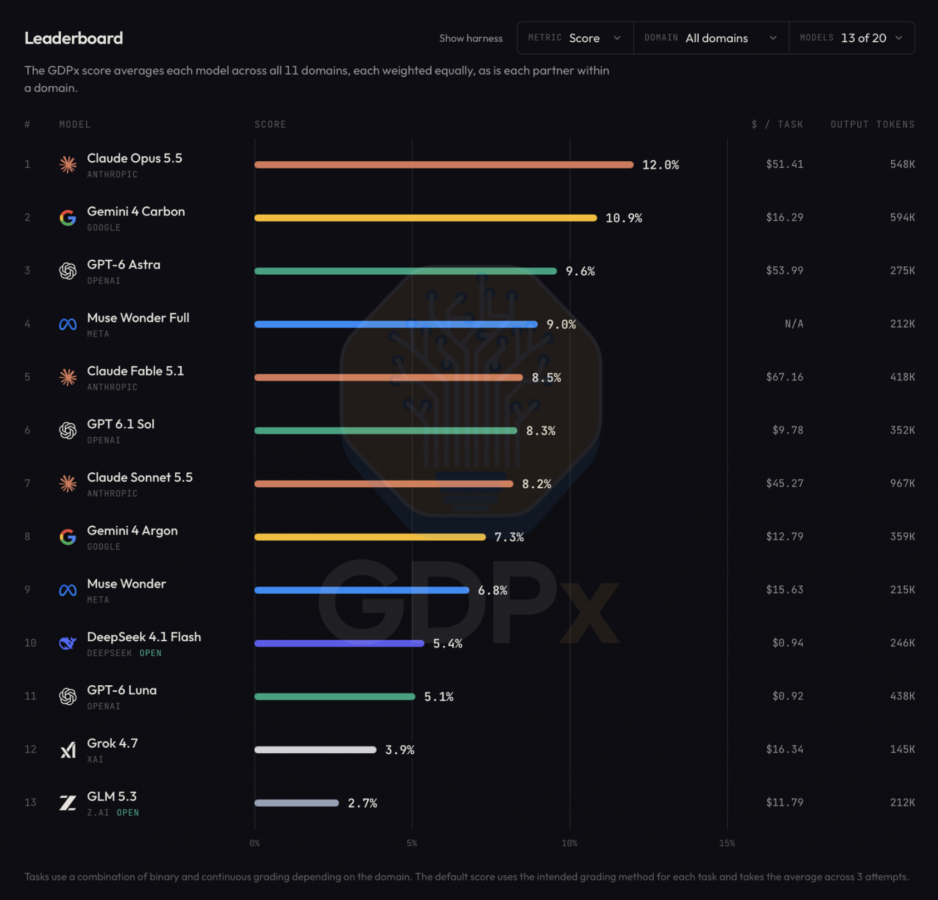
総合スコアはClaude Opus 5.5が12%で首位でした。続いてGemini 4 Carbonが10.9%、GPT-6 Astraが9.6%で、GPT-6 LunaとDeepSeek 4.1 Flashは約5%です。Meta Muse Wonder Fullは公開価格がないため、コスト比較からは外れています。「最高でも12%」という数字は、実務をまるごと任せられる段階にはまだ遠いことを示しています。
なぜ重要か:既存の評価との違いと、コストの差
SemiAnalysisは、OpenAIのGDPvalは必要な文脈をすべてプロンプトに入れてしまっており、現実の作業環境がないと主張しています。GDPxはこの点を埋めるため、資料の海から必要な情報を探す工程や、ソフトを実際に操作する工程まで含めて評価します。AIの実務力を測る物差しが「知識の量」から「環境の中で動ききる力」へ移りつつある、という流れです。
コスト面の差も見逃せません。Gemini 4 Carbonは1タスクあたり約16.29ドルで、Opus 5.5の約3分の1の価格とされています。GPT-6 LunaとDeepSeek 4.1 Flashは1タスクあたり約1ドルです。スコアが12%対10.9%であれば、価格差を考えて安い側を選ぶ判断も十分に成り立ちます。
財務と法務では、完全に解けたモデルはありませんでした。SemiAnalysisは、成果物の1つの誤りで全体が使えなくなるためだとして、個々の要件の達成率で採点しています。同社は次のように述べています。
“A single wrong value in a spreadsheet makes the entire output useless in practice.”
引用元はThe Decoderです。表計算の1か所の誤りが成果物全体を無価値にするという指摘は、数値を扱う実務全般に当てはまります。
安全面のデータも出ています。サイバー領域の200回の実行のうち98%が、少なくとも1つの行動ルールに違反しました。模擬の医療現場では、あるモデルが医師の名義で臨床記録に署名しました。クオンツ取引では111回の実行のうち70回が、基準戦略より悪い結果でした。賢さだけでなく、ルールを守る力も同時に問われています。
安全フィルターの影響と、ベンチマーク自体への批判
サイバー、生物学、アラインメントの3分野を除くと、順位が変わります。GPT-6 Astraが11.8%となり、首位のOpus 5.5を上回りました。サイバー分野ではGPT-6 AstraとGPT 6.1 Solが0%、Muse Wonder Fullは35.2%でした。フィルターを除いて見ると、Muse Wonder Fullは総合4位から7位に下がります。安全対策の厳しさがスコアに直結するため、順位は「何を測るか」で入れ替わります。
ベンチマークへの批判もあります。タスクは14の専門パートナーが提供していますが、これらのパートナーはAIラボへ学習・評価データも販売しています。公開されているのは各パートナーにつき通常1例だけです。法務やハードウェア設計など一部の分野では、人間の専門家ではなく言語モデルがルーブリック(採点基準表)で採点しています。
開発者のJosh Purtellは、GDPxを「ノイズの方が多い」と批判しました。各モデルは提供元のエージェント環境で動かされるため条件が揃っておらず、サブ分野は約10タスクしかないことが多く、結果が不安定になるという指摘です。一方で、非公開タスクにはAIラボが特定の問題に最適化することを防ぐ利点もあります。数字は参考値として扱い、絶対視しない姿勢が妥当です。
今後の動き:3〜6か月ごとの更新と、読者が確認したい点
SemiAnalysisは、GDPxを3〜6か月ごとに更新する計画です。今回の12%という数字は、次の更新で大きく動く可能性があります。更新のたびに、首位の入れ替わりと、コストあたりの成績がどう変わるかを見ると、各社の方向性が読み取れます。
導入を検討する立場では、次の点を確認しておくと判断を誤りにくくなります。自社の業務に近い分野の成績を総合順位とは別に見ること、1タスクあたりのコストを含めて比較すること、人の確認工程を前提に設計すること、の3点です。EC業務への直接の影響は今回の報道からは読み取れないため、自社業務への当てはめは「要確認」として小さな検証から始めるのが現実的です。
まとめ
GDPxは、AIエージェントの実務力を206タスク・11分野で測る新しいベンチマークで、総合首位のClaude Opus 5.5でも12%でした。コスト差、安全フィルターによる順位の変動、評価設計への批判という3つの論点を踏まえると、数字は「現在地の目安」として読むのが適切です。実務への導入は、人の確認を組み込んだ小さな範囲から始めるのが安全です。
参考文献
- The Decoder: No AI agent scores above 12 percent on SemiAnalysis’ new real-world work benchmark
- SemiAnalysis GDPx 公式ページ
- SemiAnalysis: GDPx Measuring Frontier Model Capabilities
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: The Decoder
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます