 投稿者 投稿日: カテゴリー AIニュース

GPT-6.2 AstraとSolは回答が短く直接的になった一方、透明性の評価でClaudeを下回りました。
本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。THE DECODERは2026年11月22日、AIモデルの比較評価で知られるArtificial Analysisが、OpenAIの新モデルGPT-6.2 AstraとSolの「話し方の性格」を測定した結果を報じました。報道によると、Astraの平均回答文字数は前世代から約40%減り、結論を先に言う傾向も強まりました。その一方で、不確かなことを「わからない」と認める度合いは大きく下がり、透明性の指標ではAnthropicのClaude Fable 5.2とClaude Opus 5.5に差をつけられています。生成AIを商品説明や問い合わせ対応に使う企業にとって、モデル選びの判断材料が一つ増えたニュースです。
AA-PersonalityBenchでGPT-6.2の何が測られたのか
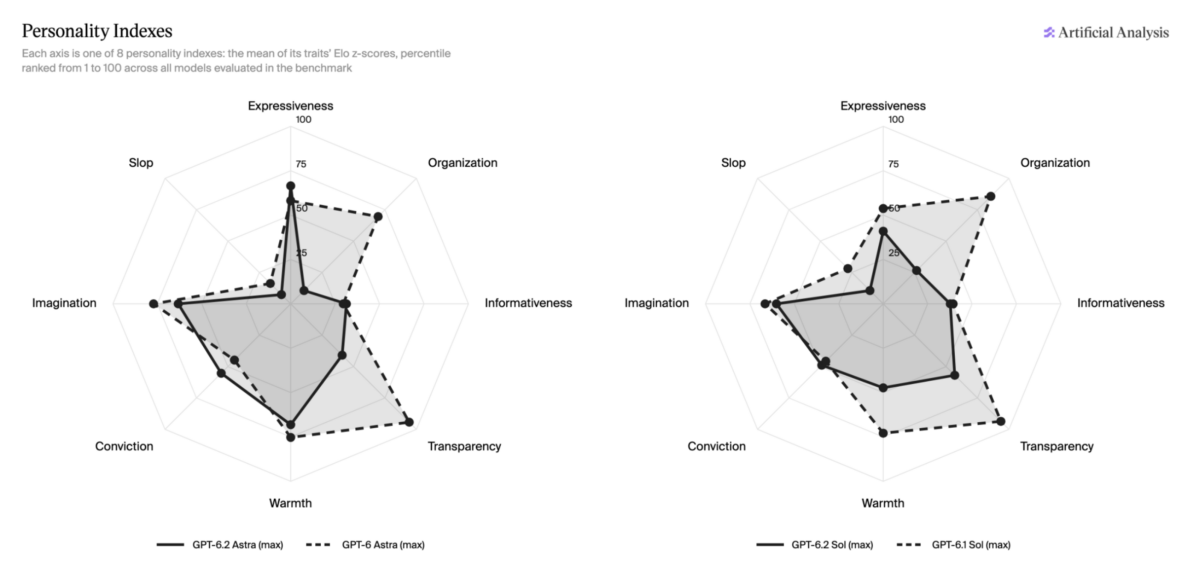
結論から言うと、今回の評価は「回答の正確さ」ではなく「回答のスタイル」を数値化したものです。AA-PersonalityBenchとは、AIモデルの話し方の傾向を30の性格特性と8つの指標で比べる、Artificial Analysisのベンチマークのことです。公式ページによると、特性ごとに30問、合計900問の質問を各モデルに答えさせ、複数のAIによる審査パネルが2つの回答を見比べて「どちらがその特性をより強く示しているか」を判定します。その結果を特性ごとのレーティングに換算し、評価対象の全モデル内での相対順位として1〜100で表します。
8つの指標は、表現力、構成力、情報量、透明性、温かさ、確信度、想像力、そして定型的で中身の薄い文章を示す「スロップ」です。これとは別に、回答の長さや見出しの数、記号の使い方といった21の文章上の特徴も直接カウントしています。点数はパーセンテージではなく相対順位である点、そしてスタイルの評価であって誤答の多さを示すものではない点には注意が必要です。
今回比較されたのは、推論の強さを最大に設定したGPT-6.2 Astra、GPT-6.2 Sol、Claude Fable 5.2、Claude Opus 5.5です。AstraはOpenAIの最上位モデル、Solは複雑な作業を低コストでこなす位置づけで、11月17日に公開されたばかりです。
回答は短く直接的に、ただし「わからない」と言わなくなった
THE DECODERが伝えた数値によると、変化は大きく2つあります。1つ目は簡潔さです。Astraの平均回答は352語から210語へ約40%、Solは337語から223語へ約34%短くなりました。1回答あたりの見出し数も、Astraは1.99から0.11へ、Solは1.85から0.25へと大きく減っています。結論を冒頭に置く「Answer First」の値は、Astraが49から89、Solが64から87へ上昇し、自然な話し言葉らしさを示す値もAstraは58から100に達しました。
2つ目は透明性の低下です。不確かさを認める特性の値は、Astraが96から24、Solが98から51へと急落しました。透明性の指標は、不確かさの自認、誠実さ、前提の明示、例外や注意点の指摘、迎合しないこと、の5特性で構成されます。この透明性指標でAstraは41、Solは57にとどまり、Claude Fable 5.2の81、Claude Opus 5.5の90と開きがあります。情報量の指標でもOpus 5.5が90と高く、Astraは31でした。
一方で、Opus 5.5はスロップ(低いほど良い)の値が20と4モデルの中で最も高く、すべての面でClaudeが勝っているわけではありません。なお、上記の個別数値はTHE DECODERの記事に基づくもので、Artificial Analysisの公式ページ上の文章では数値そのものを確認できませんでした。公式ページで確認できたのは、AstraとSolの際立つ特徴として「直接的」「自然な話し方」「結論を先に言う」が上位に挙がっている点で、記事の方向性とは一致しています。
EC実務で見るべき3つの論点
1つ目は、問い合わせ対応での「言い切り」のリスクです。返品条件や配送日、在庫など、事実確認が必要な質問に対して、AIが不確かなまま自然な口調で断定すると、誤案内が顧客トラブルにつながります。GPT-6.2系をカスタマー対応に使う場合は、「確認できない情報は推測せず、担当者に引き継ぐ」といった指示をシステムプロンプトに明記し、参照データにない質問への回答をテストで確かめておくことが重要です。
2つ目は、商品説明文の構成です。見出しの数が大きく減ったことは、楽天市場やYahoo!ショッピングの商品ページ用に見出しや箇条書きを含む長めの原稿を作らせている店舗にとって、出力の形が変わる可能性を意味します。前世代と同じプロンプトでも構成が簡素になることがあるため、「見出しを3つ付ける」など形式を明示的に指定し、切り替え前後でサンプルを比べておくと安心です。
3つ目は、用途ごとのモデルの使い分けです。チャットでの短い返答や要点整理には簡潔なGPT-6.2系、根拠や注意点を丁寧に添えたい社内レポートや比較記事にはClaude系、といった選び方が考えられます。ただし今回の数値はあくまで文体の傾向であり、自社の業務データでの精度は別途検証が必要です。
今後の動き
OpenAIはGPT-6.2向けのプロンプト指針で、回答が短すぎる場合の対処法も示しています。今回の評価結果は、簡潔さと引き換えに慎重さが下がるという設計上のトレードオフを、第三者が数字で示した事例と言えます。今後のアップデートで不確かさの表明がどこまで戻るのか、また他社モデルが同じベンチマークでどう推移するのかが注目点です。
まとめ
Artificial Analysisの評価では、GPT-6.2 AstraとSolは回答が最大約40%短くなり結論先出しが強まった一方、透明性の指標でClaude Fable 5.2とOpus 5.5を下回りました。生成AIを顧客対応や商品原稿に使うEC事業者は、断定しすぎを防ぐ指示と、切り替え前のサンプル比較を習慣にしておくと安全です。
参考文献
- THE DECODER: GPT-6.2 Astra and Sol get to the point faster but score lower on transparency than Claude
- Artificial Analysis: AA-PersonalityBench
- THE DECODER: OpenAI launches GPT-6.2 Astra and Sol with lower API prices and some benchmark gains
- THE DECODER: OpenAI shares new prompting tips for GPT-6.2 Astra and Sol
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: THE DECODER
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます