 投稿者 投稿日: カテゴリー AIニュース

OpenAIは外部委託の人間にChatGPTの実会話を読ませています。
米国の調査報道メディア404 Mediaが2026年9月14日、OpenAIが数百人規模の外部委託ワーカーを雇い、実際のChatGPT利用者のプロンプトと会話を読ませて回答品質を評価させていると報じました。社内コードネームは「Project Lily」です。しかも、モデル改善への利用は無料プラン・Plus・Proでデフォルトがオンであり、利用者が自分でオフにしない限り対象になります。ChatGPTの週間利用者は9億人を超えたと報じられている規模ですから、顧客対応の下書きや仕入交渉のメモをChatGPTに貼っているEC事業者にとって、これは他人事ではありません。本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。
Project Lilyとは何か、人間レビュアーが実際に見ているもの
Project Lilyとは、OpenAIが外部委託ワーカーにChatGPTの実会話を読ませ、回答を1から7の7段階で採点させている社内プロジェクトのことです。404 Mediaが入手した指示書によると、レビュアーの作業は三段階で進みます。まず実際の利用者のプロンプトを読み、次に「この人は何を頼もうとしているのか」を要約し、最後にChatGPTが生成した4つの回答候補を採点します。回答のどこが方針に沿っていて、どこがずれているのかを、最低3か所ハイライトして理由を書くことも求められています。
評価の狙いは、ChatGPTが人間のように振る舞うことと、過度に相手を持ち上げる追従的な応答を減らすことにあります。指示書では絵文字の乱用が減点対象として例示されており、「植樹祭の相談に木の絵文字は妥当だが、死や墜落事故の話題に骸骨や飛行機の絵文字は不適切」という具体例まで書かれていました。医療・法律・金融といった影響の大きい話題で出典が示されていない場合も減点対象です。
プライバシー面の設計はあります。レビュアーにはアカウント名が表示されず、OpenAIは会話をPrivacy Filterというモデルに通して個人情報を除去してから渡していると説明しています。ただしOpenAI自身が同モデルの説明ページで、珍しい識別子を見落としたり、文脈が短いときに削り過ぎたり削り足りなかったりすると認めています。加えて、プロンプトの上には「user memories summary」という欄が出ることがあり、その利用者が過去に何を相談してきたか、世界のどのあたりに住んでいそうかといった文脈が表示される場合があると報じられています。
日本のEC事業者にとっての3つの論点
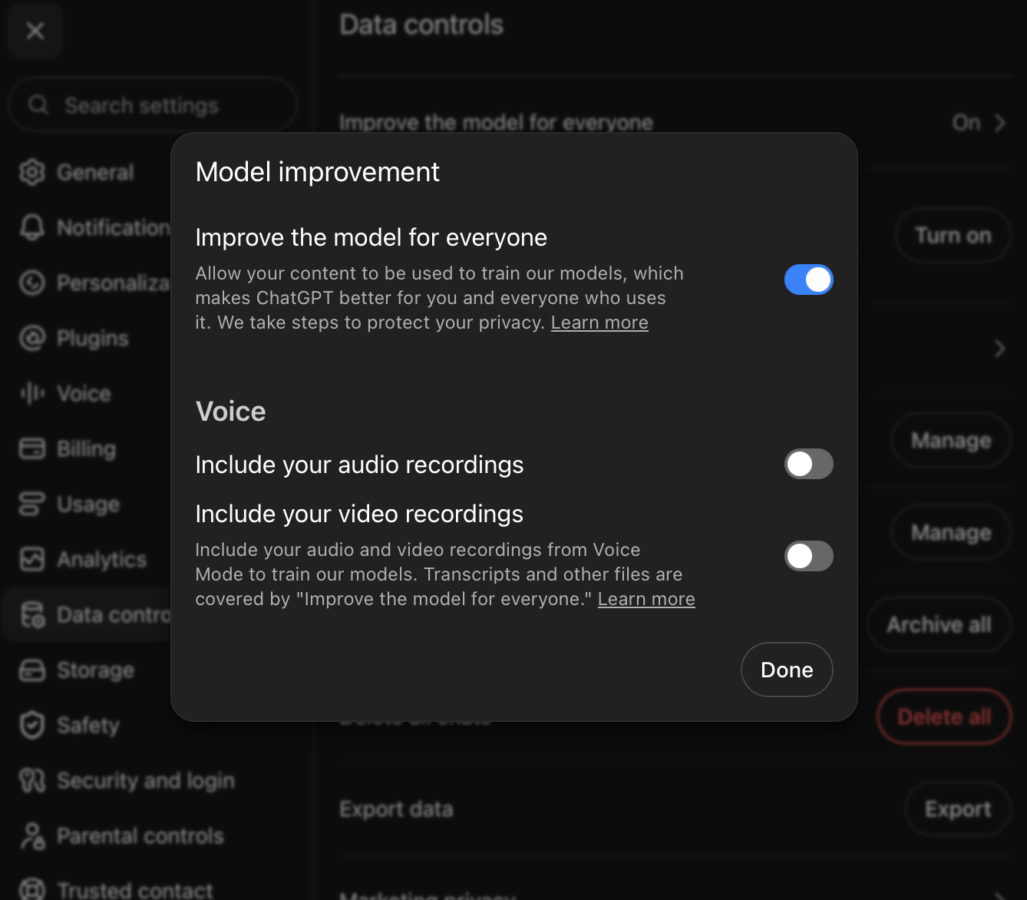
最大の論点は、プラン選択が情報管理そのものになったという点です。OpenAIは、設定画面の「improve the model for everyone(モデル改善に協力する)」をオフにすれば会話は学習に使われないとしています。この設定は無料・Plus・Proではデフォルトでオン、Enterprise・Business・Eduではデフォルトでオフです。つまり、個人向けプランを店舗の業務で使っている限り、初期状態は「提供する側」に倒れています。法人プランへの移行判断は、コストではなく情報の扱いの問題として考えるべきで、この観点はChatGPT Businessの座席単価をどう評価するかでも触れた通りです。
二つ目は、オプトアウトが遡らないという点です。404 Mediaによれば、設定をオフにしても影響するのは新しい会話だけで、過去の会話には及ばないとOpenAIは説明しています。会話を削除した場合は30日以内にシステムから削除されるとされますが、すでに匿名化されアカウントとの紐付けが外れたものは例外扱いです。今日オフにしても、昨日までに貼り付けた顧客の氏名や電話番号、仕入原価が消えるわけではないということになります。デフォルトがオンのまま学習に使われる構図は、Amazonが Twitch 配信をデフォルトでAI学習に使うと決めた件と同じ形です。
三つ目は、これがOpenAIだけの話ではないという点です。Anthropicは404 Mediaに対し、プライバシー設定の「Help improve our AI models」をオンにした利用者の会話について人間によるレビューを行っており、メールアドレスなどのアカウント識別子を外してから渡していると回答しています。GoogleのGeminiにも、保存された会話の一部を人間が確認するという趣旨の注意書きが表示されます。生成AIの回答品質は人間の採点によって支えられている、というのが業界共通の構造です。どのツールを社内標準にするかを決める前提として押さえておきたい点で、Geminiの文書共有まわりの挙動と合わせて比較する価値があります。
なお、顧客の氏名・住所・電話番号を含む問い合わせ文面をそのまま貼る運用が個人情報保護法上どう整理されるかは、契約形態や委託構造によって変わります。断定はできませんので、自社の顧問弁護士や社労士に確認してください(要確認)。
今日中にやる3つの設定確認と社内ルール
最初にやるべきは、店舗で使っている全アカウントの設定を1つずつ開いて、モデル改善への協力がオンになっていないかを確認することです。OpenAIのデータ管理に関するFAQにオフにする手順が載っています。個人のPlusアカウントを業務に流用しているスタッフがいないか、この機会に棚卸ししてください。パート・アルバイトを含めると、把握していないアカウントが2つ3つ出てくる店舗は珍しくありません。
次に、貼っていい情報と貼ってはいけない情報の線を1枚の紙に落とします。線引きは難しく考えず、「これが知らない誰かの画面に表示されても困らないか」で判断すれば十分です。顧客の氏名・住所・電話番号・注文番号、仕入先名と原価、未公開のセール価格と開始日、従業員の個人情報。この4つは貼らない、と決めて共有するだけで事故の大半は防げます。問い合わせ対応の下書きをAIに作らせたいときは、固有名詞を「お客様A」「商品B」に置き換えてから貼る運用にします。
三つ目は、契約の見直しです。学習利用がデフォルトでオフになるのは Enterprise・Business・Edu です。月あたりの座席コストは増えますが、顧客データを日常的に扱う担当者だけでも法人プランに寄せる価値はあります。その際、APIを使った自社ツール側の扱いも合わせて整理しておくと、社内ツールの内製とSaaS利用の線引きが一度で片付きます。
もう一点、報道では委託構造にも触れられています。北米在住のワーカーは時給50ドル超で、Crossing Hurdlesという人材紹介会社経由で仕事を得ており、実際の支払いはAI学習企業のMercorが行っているとのことです。Metaは2026年4月、データ侵害を受けてMercorとの取引を停止しています。会話データがどこまでの階層を経由するのかは、利用者からは見えません。
まとめ
ChatGPTの会話を人間が読んでいるという事実そのものは、品質改善の手段として不当ではありません。問題は、無料・Plus・Proではそれがデフォルトで有効であり、OpenAIがヘルプページを更新した後もなお「人間が読む可能性がある」とは明記していない点です。EC事業者がとるべきスタンスは単純で、設定を今日確認し、貼らない情報の線を紙で共有し、顧客データに触れる担当者は法人プランに寄せる。この3つを今週中に終わらせれば十分です。
参考文献
- 404 Media|Inside ‘Project Lily’: The Humans Reading Your ChatGPT Chats
- OpenAI|Introducing OpenAI Privacy Filter
- OpenAI Help Center|Data Controls FAQ
- OpenAI Help Center|How your data is used to improve model performance
- OpenAI|Privacy Policy
- TechCrunch|ChatGPT reaches 900M weekly active users
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: 404 Media
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます