 投稿者 投稿日: カテゴリー AIニュース

最上位のGPT-6 Astraでも、実在のWebアプリ修正を完全にこなせたのは26.4%の課題だけでした。
本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。Co-Design Benchとは、既存のWebアプリを利用者の変更依頼どおりに修正できるかを測る、コーディングエージェント向けのベンチマーク(性能比較テスト)のことです。The Decoderは2026年11月8日、Alibabaと複数のアジアの大学の研究者による論文を取り上げました。10モデルを比べた結果、ほぼ4件に3件は人の手直しが要る水準だったと報じています。
何が起きたか:実際の依頼を再現した新ベンチマーク
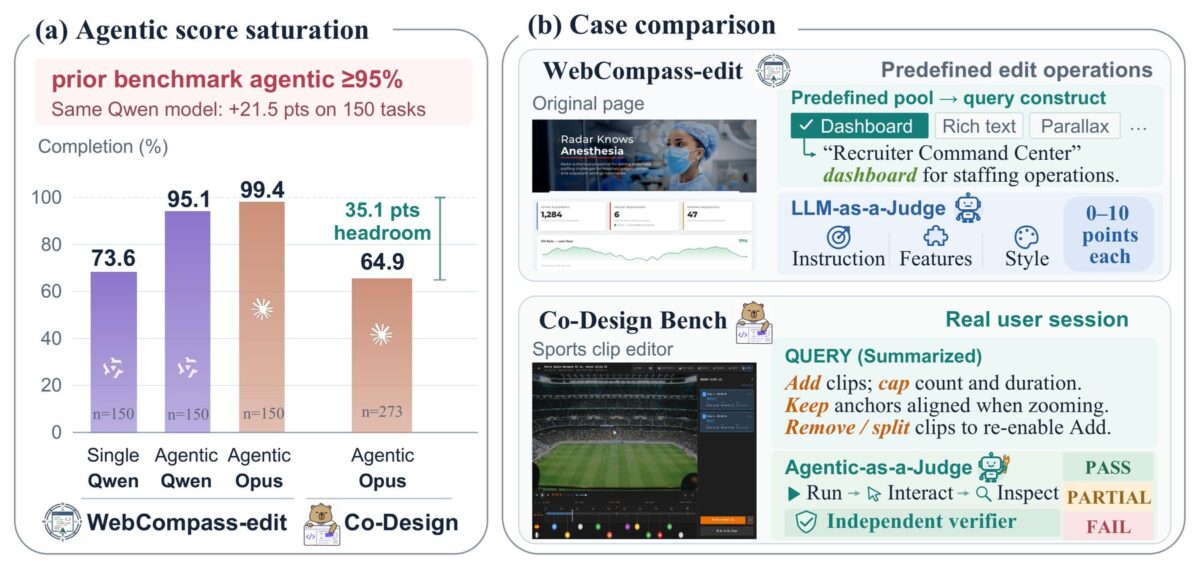
Co-Design Benchは、実際のコーディングセッションで利用者が言い直したり巻き戻したりした依頼を中心に課題を組んでいます。入力には画像、音声、動画、文書が含まれることがあり、小さな修正から大規模な改修まで幅があります。採点はAI審査員がブラウザ上でアプリを実際に動かして判定し、別のAI審査員がプラス判定を再確認して、見せかけの画面やハードコードされた結果がないかを調べる方式です。
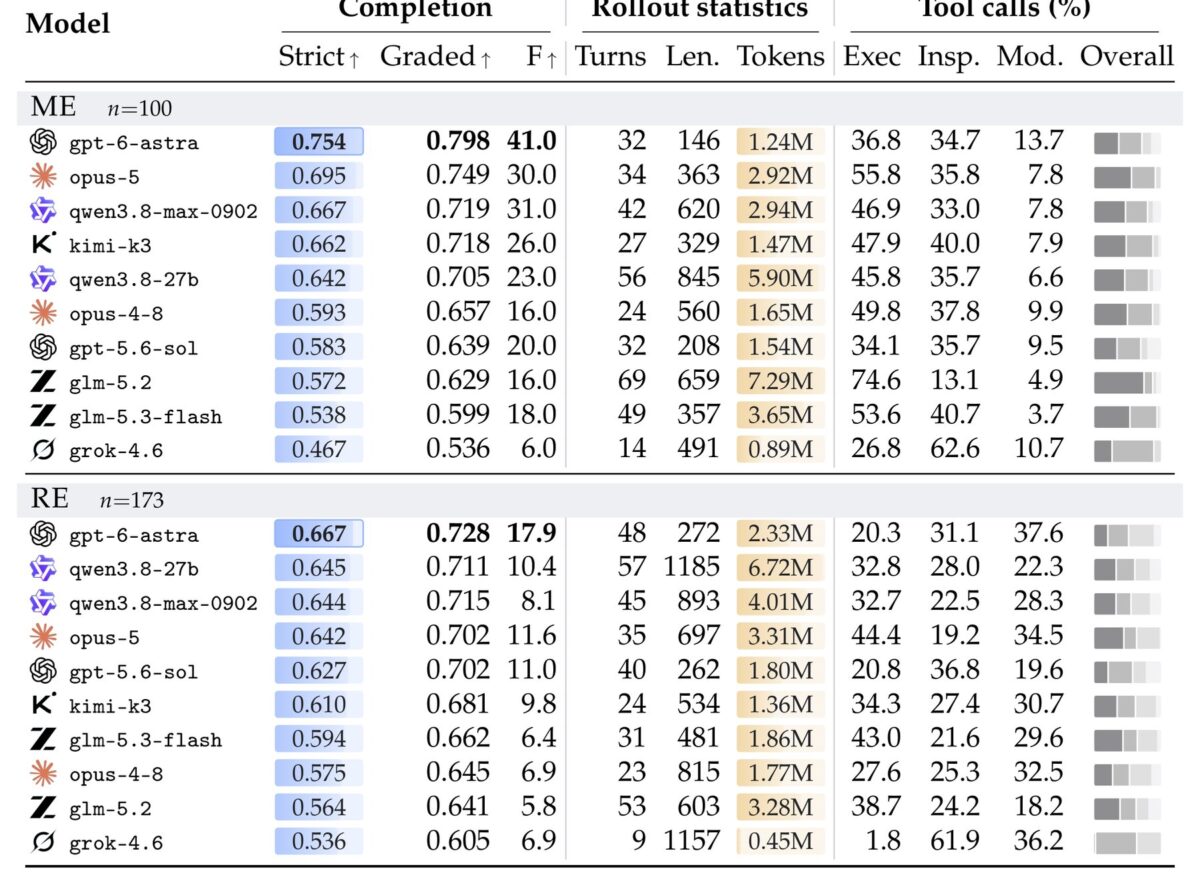
結果は、最上位のGPT-6 Astraでも要件の平均約70%を満たしたにとどまり、完全に正しく動いたのは26.4%のタスクだけでした。続くのはClaude Opus 5とQwen3.8-Max、最下位はGrok 4.6です。GPT-6 Astraはマルチモーダル課題の41%を完全に解きましたが、リポジトリ課題では18%弱でした。
著者らが新しい試験を用意した理由は、既存ベンチマークの飽和にあります。記事によると、WebCompass-editなど従来のテストでは99%超を記録するモデルが、Co-Design Benchでは35ポイント超も下がりました。
なぜ重要か:数字が示す3つの論点
第一の論点は、変更の種類が増えるほど成績が落ちることです。レイアウト、デザイン、インタラクション、内容のうち3〜4種類を同時に変える依頼になると、全10モデルの成績が下がりました。現場の依頼は一度に複数の変更を含みがちなので、単発の修正で得た印象より実務は厳しいと読めます。
第二の論点は、モデルだけでなくハーネス(エージェントがコードを読み書き・実行する仕組み)の影響が大きいことです。小型のQwen3.8-27Bは大規模改修で、環境によって75%にも56%にもなり、どちらのモデルが上かも環境で入れ替わりました。大規模改修では同モデルが2位に上がりましたが、著者はこれをモデルの一般的な優位とは見ていません。記事は「Leaderboards that list only the model therefore only tell part of the story.」と述べています。
第三の論点は、コストの効率です。GLM-5.2は小さな変更でGPT-6 Astraの約6倍のトークンを消費しながら、成績は大きく劣りました。トークンを多く使うほど良い結果になるとは限りません。
関連して、記事はMETRの調査にも触れています。プロジェクト管理者によるAI生成コードの採用率は、SWE-bench Verifiedのスコアより約24ポイント低かったとされています。
今後の動き:注意したい4点
一つ目は、著者自身が挙げる限界です。各課題は依頼が1回のみで、途中の質問や訂正は含まれず、AI審査員も誤る可能性があります。二つ目は、この結果が今後のモデル更新でどう動くかです。三つ目は、ベンチマーク公開後に各社がどう対応するかで、既存テストが飽和した前例を考えると、新しいテストもいずれ高得点が並ぶ可能性があります。四つ目は、ハーネス込みで評価する流れが広がるかどうかです。
筆者の見方では、社内でコーディングAIを使う場合、リーダーボードの順位だけで選ばず、自社の依頼に近い複数の変更を含む課題で試す方が安全です。これは筆者の考察であり、The Decoderの主張ではありません。
まとめ
Co-Design Benchでは、最上位モデルでも完全に正しく動いたのは26.4%の課題でした。変更の種類が増えると成績が下がり、同じモデルでも環境で結果が大きく変わります。モデルの順位表だけでなく、実際の依頼に近い条件での検証が欠かせません。数字はいずれも報道とベンチマーク作成者の報告に基づきます。
参考文献
- The Decoder: AI coding agents still need human cleanup on nearly three out of four tasks in a real-world test
- arXiv: Co-Design Bench (2610.35138)
- Co-Design Bench 公式サイト
- The Decoder: METR調査の紹介記事
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: The Decoder
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます