 投稿者 投稿日: カテゴリー AIニュース

オープンソースのOCRモデルは、18か月で処理コストがおよそ5分の1に下がりました。
本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。AI専門メディアのTHE DECODERは、Hugging FaceのDaniel van Strienが公開した比較検証をもとに、無料で使えるOCRモデルで100万ページを読み取るGPU費用が65〜130ドルまで下がったと報じました。OCRとは、紙やスキャン画像に写った文字をデータとして読み取る技術のことです。請求書、納品書、紙のカタログ、仕入先の価格表を手入力しているEC事業者にとって、この価格帯は「外注するか、自社で回すか」の判断を変える水準です。本記事では検証の中身を整理し、日本のEC事業者が押さえるべき3つの論点をまとめます。
オープンOCRモデル8種の比較で何がわかったか
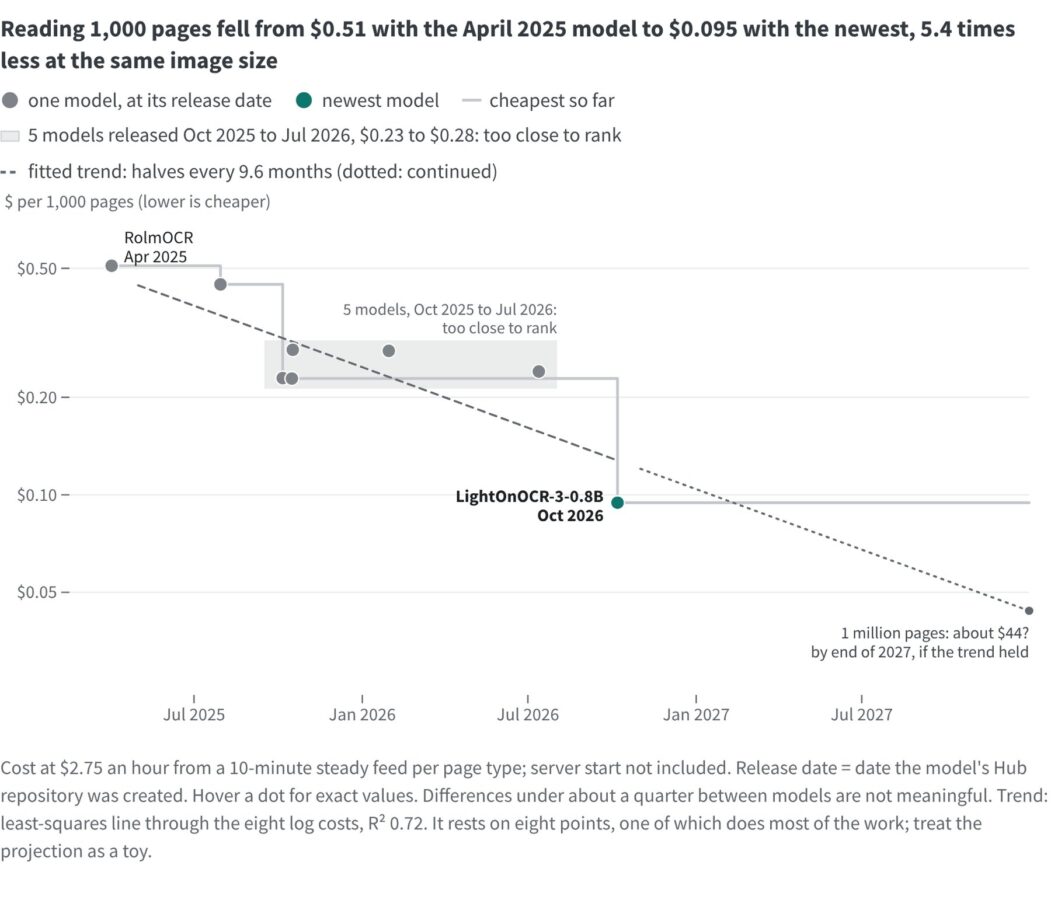
結論として、2026年10月公開の最新モデルは、1,000ページあたり約0.095ドルで、2025年4月の旧モデルの約5分の1のコストに収まりました。検証を行ったvan Strienは、自身のブログ記事で、8つのオープンモデルを同じ条件で走らせた結果を公開しています。
比較対象は、2025年4月のRolmOCRから、dots.ocr、olmOCR-2、PaddleOCR-VL、DeepSeek-OCR、GLM-OCR、OvisOCR2を経て、2026年10月のLightOnOCR-3-0.8Bまでの8種です。RolmOCRは1,000ページあたり約0.51ドル、中間の5モデルはおおむね0.23〜0.28ドルで横並び、最新のLightOnOCR-3-0.8Bが約0.095ドルでした。
テストに使われたのは合計850ページです。内訳は、博物学の古書350ページ、1771年版ブリタニカ百科事典250ページ、20世紀後半を中心としたタイプ打ち・印刷のアーカイブ文書250ページでした。処理には1時間2.75ドルでレンタルしたNvidia RTX PRO 6000を1枚使い、推論エンジンはvLLMです。タイプ打ち文書では平均で毎秒7.6ページを処理しており、混在した100万ページなら1枚のGPUで約1日半という試算も示されています。
精度面では、人がチェックした古書282ページでの誤り率の中央値が、モデルごとに0.44〜0.82%の範囲でした。最新モデルは、2025年4月のモデルと比べて誤りが増えていません。つまり「安くなったが質が落ちた」という話ではない点が重要です。
日本のEC事業者にとっての論点
1つ目の論点は、モデルの乗り換えよりも「回し方」で費用が大きく変わることです。検証では、GLM-OCRでブリタニカのページを処理した費用が、旧来の設定で1,000ページあたり1.57ドル、バッチの流し方や画像サイズ、エンジンの版、GPUを見直すと0.40ドル、最新モデルに替えて0.13ドルになりました。フルサイズのスキャンは1.3〜4.2倍の費用がかかる一方、古書ページの精度は上がらなかったとされています。楽天市場やAmazonの出品作業で、仕入先から届くPDFや紙の商品仕様書を読み込む場合も、まず画像の解像度と処理のまとめ方を見直すだけで原価が下がる可能性があります。
2つ目の論点は、小さなGPUでも実用的な価格になったことです。16GBのT4(1時間0.40ドル)でLightOnOCR-3-0.8Bを動かした場合でも、1,000ページあたり約0.25〜0.41ドルに収まりました。100万ページ65〜130ドルという水準は、1ドル150円で換算すると約1万〜2万円です(為替は要確認)。月に数千枚の伝票を扱う中小規模の店舗なら、GPU費用はごく小さな額になります。人手入力の時給と比べれば、費用面の壁はほぼなくなったと言えます。
3つ目の論点は、誤読の「型」を知らないと事故につながることです。白紙ページに対して、あるモデルは画像の説明文を書き、別のモデルは定型の英文を返し、RolmOCRは存在しない表をでっち上げました。ドットリーダー(点線)入りの税務書式では、8モデル中4モデルが同じ出力を繰り返すループに陥り、最新モデルもその中に含まれていました。染みのあるタイプ文書では、3モデルが最後の行を勝手に作り、迷っている様子も見せなかったと報告されています。請求金額や品番、JANコードのように1文字の誤りが損失に直結するデータでは、人の確認工程を残す設計が欠かせません。
なお、今回の検証は英語を中心とした歴史資料で行われており、日本語の請求書や縦書き資料での精度は検証されていません。日本語での実力は要確認です。以前取り上げたMistral OCR 4の解説や請求書の構造化に関する記事と同じく、自社書類のサンプルで試してから導入範囲を決めるのが安全です。
今後の展望と初動アクション
van Strienが引いた傾向線では、コストはおよそ9.6〜10か月ごとに半減しています。ただし本人もこの線を、8モデルだけに基づく「おもちゃ」の推定だと断っており、将来の価格を約束するものではありません。それでも、OCRが「高いから一部だけ」から「全部読ませてから選ぶ」段階に入ったことは確かです。
初動として、まず自社で手入力している書類を棚卸しし、月間の枚数と1枚あたりの入力時間を把握することをおすすめします。次に、請求書、納品書、商品仕様書などの実物から50〜100枚程度を抜き出し、オープンモデルと有料APIの両方で読み取りを比べます。最後に、金額や品番の欄だけは二重チェックする運用ルールを決め、白紙ページや汚れのある書類を除外する前処理を入れておくと、上で触れた誤読の型による事故を減らせます。
まとめ
オープンOCRは18か月で約5分の1の価格になり、100万ページを65〜130ドルで読める水準に達しました。精度は落ちておらず、画像サイズや処理方法の見直しでさらに費用を下げられます。一方で白紙や書式によっては作り話やループが起きるため、日本のEC事業者は日本語書類で小さく試し、確認工程を残したうえで帳票業務の自動化を進めるのが現実的です。
参考文献
- THE DECODER「OCR models now digitize a million pages for under $130 as costs drop fivefold in 18 months」
- Daniel van Strien「OCR cost trend」検証記事
- Hugging Face LightOnOCR-3-0.8B モデルページ
- Hugging Face RolmOCR モデルページ
- Hugging Face Jobs 公式ドキュメント
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: THE DECODER
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます