 投稿者 投稿日: カテゴリー AIニュース

Grok 4.7とは、xAIが2026年9月に公開した最新のAIモデルのことです。
入力100万トークンあたり2ドル、出力6ドルという低価格が最大の特徴です。ただし独立系ベンチマークの総合スコアは46にとどまり、53を記録した上位2モデルに差をつけられました。エージェント型のコーディング評価では26パーセントと、上位モデルの半分以下です。安さと実力が明確にねじれたこのリリースは、生成AIを商品ページ制作や業務自動化に使い始めた日本のEC事業者にとって、モデル選定の考え方を見直す材料になります。本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。
Grok 4.7の価格と実力、公表数値の中身
結論から言えば、Grok 4.7は価格で明確に勝ち、総合的な知能指標とエージェント性能で明確に負けています。The Decoderが2026年9月21日に報じた内容と、xAIの公式発表であるGrok 4.7のリリース情報から、数字を整理します。
価格は入力100万トークンあたり2ドル、出力100万トークンあたり6ドルです。xAIはこのモデルについて、より大きなベースモデルの上に構築し、強化学習の期間を長くとり、自分の出力を検証する能力を高めたとしています。コーディングとナレッジワークにおける同社の最高性能モデルという位置づけです。
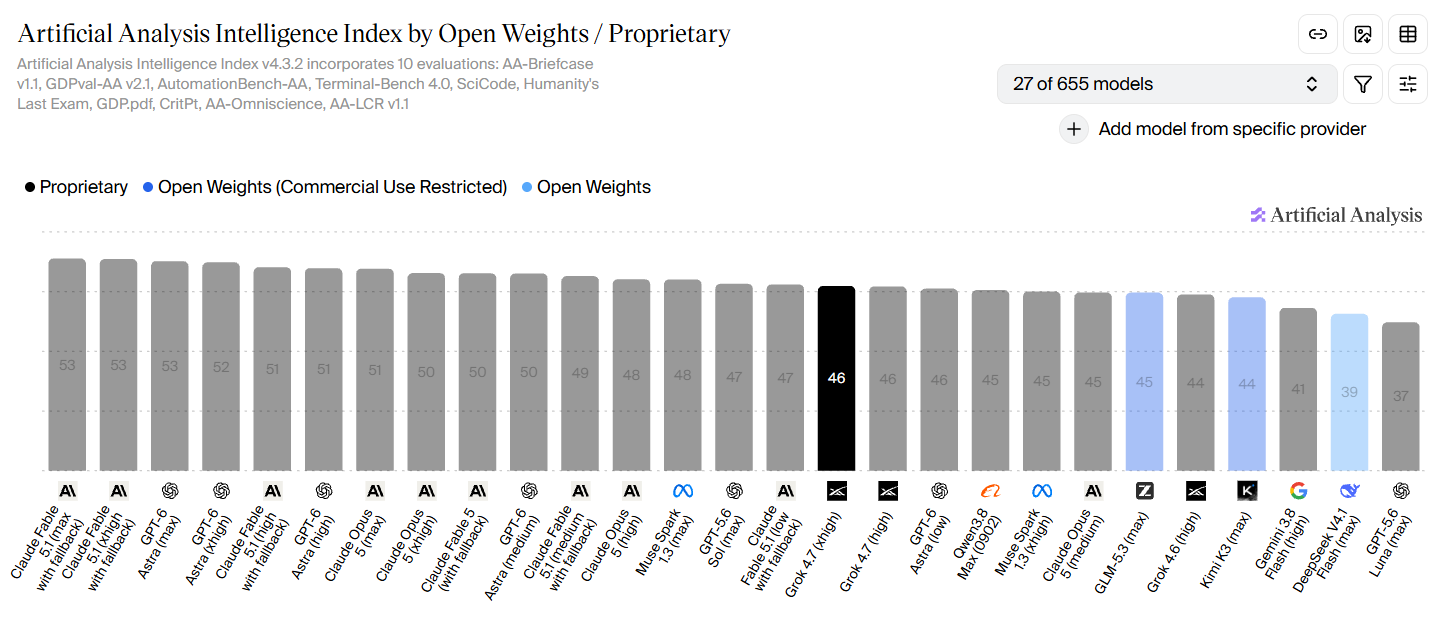
一方で、10のベンチマークを統合する独立系のArtificial Analysis Intelligence Index(v4.3.2)では、Grok 4.7のスコアは46でした。同じ指標でClaude Fable 5.1とGPT-6がそれぞれ53を記録しており、7ポイントの差があります。中位グループに位置する、という評価です。
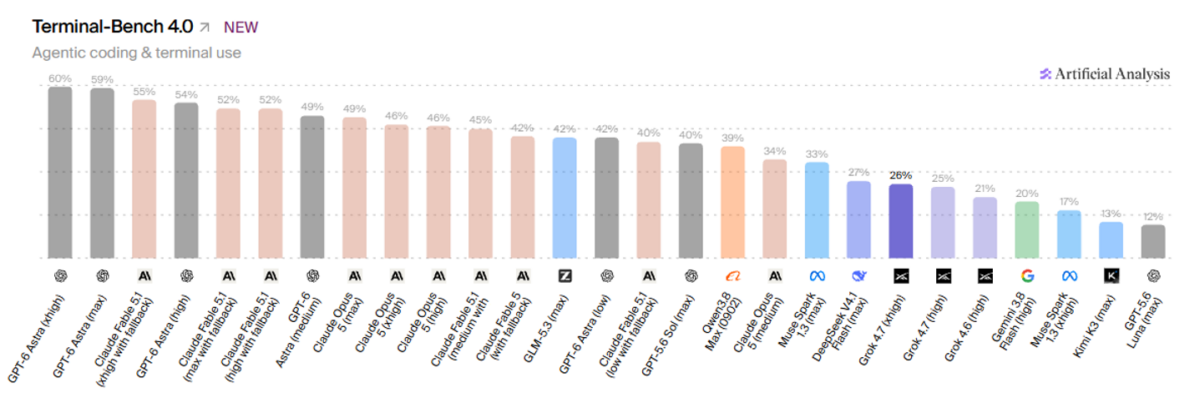
差がさらに広がるのが、エージェント型コーディングの評価です。Terminal-Bench 4.0でGrok 4.7は26パーセントでした。GPT-6 Astraの60パーセント、Claude Fable 5.1の55パーセントと比べると、半分以下の水準です。低価格帯のDeepSeek V4.1 Flashの27パーセントにもわずかに及びませんでした。
提供経路はGrok APIのほか、CursorとGrok Buildです。開発ツール経由でも触れる状態になっています。
なお、こうした知能指数は指標側のバージョン改定で絶対値が動きます。今回の46はv4.3.2での数値であり、過去のバージョンで報じられたスコアと単純に並べて比較することはできません。社内資料に転記する際は、指標名とバージョンをセットで残しておくことをおすすめします。
日本のEC事業者にとっての論点は単価ではなく工程
結論として、価格差が効くのは大量生成の工程で、性能差が効くのは自動実行の工程です。この2つを分けずに「安いモデルへ一括で寄せる」判断をすると、片方でコストを削って片方で事故を増やすことになります。
価格差が直撃するのは、商品説明文の一括生成、レビューの要約、広告文案の量産といった処理です。たとえば楽天市場やYahoo!ショッピングの店舗が、1商品あたり入力2,000トークン・出力800トークンの想定で1,000SKU分の説明文を生成するとします。入力は合計200万トークン、出力は80万トークンです。Grok 4.7の公表価格で計算すると、入力が約4ドル、出力が約4.8ドルで、合計およそ8.8ドルになります。
この差をどう見るかは、比較対象の価格次第です。The Neuronの比較記事では、GPT-6 AstraとClaude Fable 5.1の標準API価格を入力10ドル・出力50ドルとしています。この数値で同じ条件を計算すると約60ドルとなり、おおむね7倍の開きです。ただし各社の価格は改定やバッチ割引、キャッシュ割引で変動するため、実際の請求額は自社の利用形態で必ず検証してください(比較価格は要確認)。
性能差が効くのは、逆側の工程です。在庫データの突合、受注CSVの加工、複数の管理画面をまたぐ定型作業の自動化など、AIに手順を実行させる領域では、Terminal-Bench 4.0が示した26パーセントと55から60パーセントという差がそのまま失敗率の差になりかねません。Amazonの出品データ更新やShopifyの在庫同期のように、間違えた瞬間に売上と顧客体験へ直結する工程は、ここでコストを削る場所ではありません。
つまり、Grok 4.7の低価格はEC事業者にとって朗報ですが、それは「文章をたくさん作る工程」に限った朗報だという理解が必要です。
明日からの初動、3つの手順
結論として、いきなり切り替えず、工程を切り分けて実測するのが最短です。
第一に、生成AIを使っている業務の棚卸しをします。基準は単純で、大量の文章を生成しているだけの工程か、外部システムへの書き込みや実行を伴う工程かの二択です。多くの店舗では、商品説明文とメルマガ文案が前者、在庫更新と受注処理が後者に入ります。
第二に、前者の工程だけで並走テストを行います。同じプロンプトで30件から50件を現行モデルとGrok 4.7の両方に通し、出力品質とトークン消費量を並べて比較します。ここで品質が実用水準なら、その工程だけ切り替えればコストが下がります。判断材料を数字で残すことが重要です。
第三に、後者の自動実行系は上位モデルのまま維持し、実行ログを必ず残す設計にします。価格差に釣られて実行系を置き換えると、失敗時の差し戻し工数が削減額を上回る可能性があります。
加えて、四半期に一度はベンチマークを見直す運用をおすすめします。モデルは数か月単位で更新され、指標のバージョンも変わります。年に一度の選定では、すでに実態と合わなくなっているためです。
まとめ
Grok 4.7は入力2ドル・出力6ドルという価格で登場しましたが、総合指数46、エージェント型コーディング26パーセントという数字は、上位モデルとの実力差をはっきり示しています。日本のEC事業者が取るべきスタンスは、モデルを一本に決めることではなく、工程ごとに使い分ける前提で自社の業務を分類することです。大量生成は安いモデルへ、実行を伴う工程は性能の高いモデルへ。この線引きを自社の数字で確認するところから始めてください。
参考文献
- The Decoder – xAI launches Grok 4.7 at bargain prices, but benchmarks reveal a wide gap to Claude and GPT-6
- xAI – Grok 4.7 公式リリース
- Artificial Analysis – Grok 4.7 モデル評価ページ
- The Neuron – Grok 4.7 vs. GPT-6 Astra and Claude Fable 5.1
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: The Decoder
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます