 投稿者 投稿日: カテゴリー AIニュース

AllSparkが検索エージェントIrisをオープンウェイトで公開しました。
中国の研究チームAllSparkが2026年9月13日、自律的にウェブを調べて答えを出す検索エージェント「Iris-mini」(350億パラメータ)と「Iris-pro」(3,970億パラメータ)を、重みを公開する形でリリースしました。同クラスのオープンウェイトモデルとして最上位の精度を主張しており、EC事業者にとっては競合調査や仕入れリサーチを外部APIに頼らず自社側で回す選択肢が一段現実的になった、という意味を持ちます。本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が、日本のEC事業者にとっての論点を3つに絞って解説します。
何が起きたか|35Bと397Bの検索エージェントが重みごと公開
結論として、今回公開されたのは「モデル」だけでなく「検索エージェントを動かす一式」です。The Decoderによると、AllSparkはIris-miniとIris-proの2モデルに加えて、エージェントループ・ツール・コンテキスト管理戦略・評価用ベンチマークをまとめた「Iris Harness」を同時に公開しました。モデルの重みはHugging Faceのコレクションに、コードはGitHubに置かれています。
検索エージェントとは、質問を理解し、何を検索するか自分で決め、結果を読み解き、答えを出すのに十分な根拠が集まったかを判断するAIのことです。人が検索窓にキーワードを入れて回答を読む作業を、モデル側がループで回します。
2モデルはいずれもAlibabaのQwen系をベースにしており、Iris-miniはQwen3.6-35B-A3B、Iris-proはQwen3.5-397B-A17Bを土台としています。コンテキストウィンドウはどちらも25万6,000トークンです。ベンチマークでは、コンテキスト管理を有効にした条件でIris-miniがBrowseComp 82.2、BrowseComp-ZH 84.8、DeepSearchQA 86.9、Humanity’s Last Exam 52.3、Iris-proがそれぞれ88.6、85.1、92.9、56.4を記録したと論文は述べています。小型クラスではIris-miniが4指標のうち3つで首位、DeepSearchQAのみ他モデルに譲ったとされています。
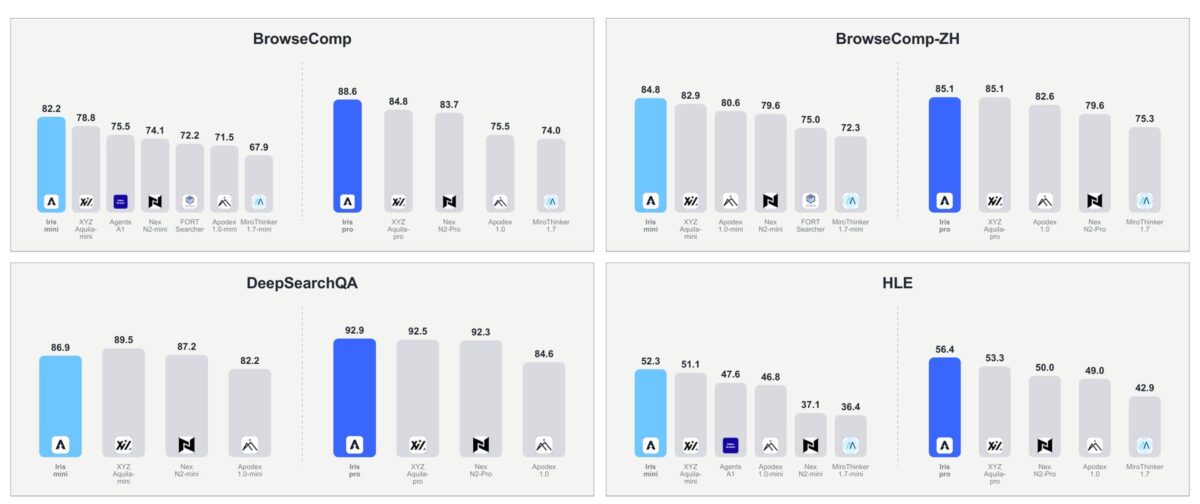
もうひとつ注目したいのは、チーム自身が「実行時のコンテキスト管理の差が、モデル間の性能差より大きく効いている場合がある」と指摘している点です。長い調査を続けるとコンテキストが埋まり、途中で打ち切られます。会話履歴を捨てて調査を延命させる手法を使うかどうかで、Iris-miniのBrowseCompスコアは最大21.2ポイント動いたとされています。ベンチマークの数字は、モデルの実力と外側の仕組みの合計値だという前提で読む必要があります。
日本のEC事業者にとっての3つの論点
論点は3つあります。調査業務の内製可否、データを外に出さない運用、そして数字の読み方です。
第一に、商品リサーチと競合調査の内製です。楽天市場やAmazonの店舗運営では、競合の価格改定、レビューの論点、新規参入ブランドの動きを継続的に追う作業が発生します。これまでは外部の検索API付きモデルに都度課金するか、人手でやるかの二択でした。オープンウェイトの検索エージェントが手に入ると、自社サーバやクラウドのGPU上で動かし、実行回数あたりの変動費を電力とインフラ費に置き換える選択肢が加わります。Iris Harnessは OpenAI互換エンドポイントであれば動くとされているため、既存の社内LLM基盤に接続しやすい構造です。
第二に、顧客データや仕入れ情報を社外に出さない運用です。仕入価格、原価、取引先名、未公開の商品企画といった情報をプロンプトに含めて調査させたい場面は少なくありません。外部APIに投げる前提だと社内規程で止まるケースがありますが、重みが手元にあるモデルなら、調査対象のウェブ検索部分だけを外に出し、機密文字列は自社環境に留める設計が組めます。ただし実際にどこまで閉じられるかは、検索ツールの構成次第です。導入前に通信経路を必ず確認してください。
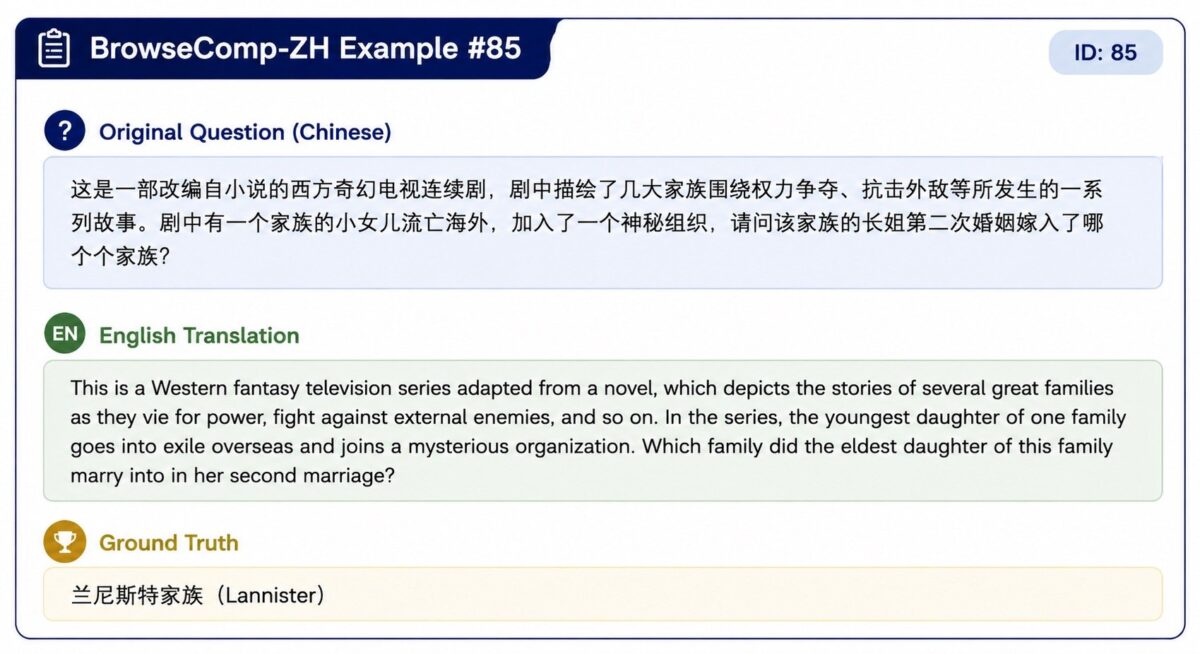
第三に、ベンチマーク数字の読み方です。Iris-proのDeepSearchQA 92.9という数字は魅力的ですが、これは英語と中国語を中心とした評価であり、日本語の商品名・型番・カタカナ表記が混じる日本のEC調査での実力を保証するものではありません。日本語環境での精度は各社が自前で測る必要があります。論文の付録では、正解データ側が誤っていたためにエージェントの正答が不正解と判定された事例も報告されており、評価そのものの難しさが示されています。
初動アクション|まず自社の調査業務を3つに仕分ける
いま取るべき初動は、モデルの検証ではなく業務の棚卸しです。
まず、自社で繰り返している調査業務を「毎日やる定型調査」「週次の競合モニタリング」「不定期の深掘り調査」の3つに仕分けます。検索エージェントが最初に効くのは1つめと2つめで、投入する手間に対して回収が読みやすい領域です。
次に、その定型調査を日本語のテスト問題10件程度に落とし込みます。競合3社の送料無料ラインを調べる、指定カテゴリの売れ筋レビューで言及が多い不満点を3つ挙げる、といった粒度です。正解は人が先に作っておきます。
そのうえで、いま使っている生成AIサービスと、社内GPUで動かしたオープンウェイトモデルの両方に同じ10件を解かせ、正答率と1件あたりのコストを並べます。この比較をせずにモデルを入れ替えると、安くなったが精度が落ちたという状態に気づけません。
最後に、機密情報の扱い方針を先に決めます。原価や取引先名をプロンプトに入れるのか入れないのかを決めてから、どのモデルを使うかを選ぶ順番にしてください。順番が逆になると、あとから使えない仕組みが残ります。
まとめ
オープンウェイトの検索エージェントが同クラス上位の精度を主張する段階に入り、EC事業者の調査業務を自社側で回す選択肢が増えました。一方で、公開されている数字は英語・中国語中心の評価であり、コンテキスト管理という外側の仕組みにも大きく左右されます。日本のEC事業者としては、自社の定型調査を10件のテスト問題に落として実測し、機密情報の扱い方針を先に固めるところから始めるのが現実的です。
参考文献
- THE DECODER|Iris-mini and Iris-pro are the strongest open-weight search agents in their class
- Hugging Face|AllSpark-Research / Iris collection
- GitHub|AllSpark-Research/Iris
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: THE DECODER
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます