 投稿者 投稿日: カテゴリー AIニュース

ElevenLabsは2026年11月、音声認識Scribe v3を公開しました。
本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。音声AI企業のElevenLabsが発表したScribe v3とScribe v3 Liveは、録音済み音声とリアルタイム音声のそれぞれに向けた新しい音声認識(音声を文字に起こす技術)モデルです。同社によると、Scribe v3は前世代に比べて102言語平均で単語の誤認識が27%減り、リアルタイム版のScribe v3 Liveは意味ベースの誤認識が43%減りました。とくに注目したいのは、電話口のAIが相手の話を途中でさえぎってしまう問題への対策です。電話注文や問い合わせ窓口を持つEC事業者にとって何が変わるのか、事実関係と論点を整理します。
Scribe v3とは何か、発表内容の事実関係
Scribe v3とは、ElevenLabsが2026年11月10日に公開した、録音済み音声向けの音声認識モデルのことです。同時に公開されたScribe v3 Liveは、低遅延が求められるリアルタイム用途向けで、電話応対をするAI音声エージェントでの利用が想定されています。どちらも開発者向けのElevenAPIで利用でき、Scribe v3 Liveは音声エージェント構築基盤のElevenAgentsでもすでに使えます。前世代からの切り替えは、モデルIDをscribe_v3またはscribe_v3_liveに変えるだけだと説明されています。
精度についてElevenLabsは、録音向けのScribe v3で単語誤り率が102言語平均で27%下がり、テストしたすべての言語で改善したとしています。言語別ではドイツ語が42%、スペイン語が35%、英語が23%の改善です。誰が話したかを区別する話者分離の誤りも全体で12%、3人以上が話す録音では17%減りました。リアルタイム向けのScribe v3 Liveは、前世代のリアルタイム版と比べて意味ベースの誤り率が43%、単語誤り率が31%下がり、話者分離がリアルタイムで初めて使えるようになっています。いずれも同社自身の評価であり、日本語に限った数値は公表されていません。
第三者の評価も出ています。The Decoderによると、Artificial AnalysisのベンチマークでScribe v3は、Microsoft、Mistral、xAI、Google、OpenAIのモデルをわずかに上回り、Alibabaのプレビュー版に次ぐ精度でした。一方で速度は中位にとどまり、ベンチマーク上の価格は1,000分あたり3.33ドルです。MicrosoftやxAIのモデルは誤り率がわずかに高いものの、何倍も速く、価格はおよそ半分だと同メディアは伝えています。
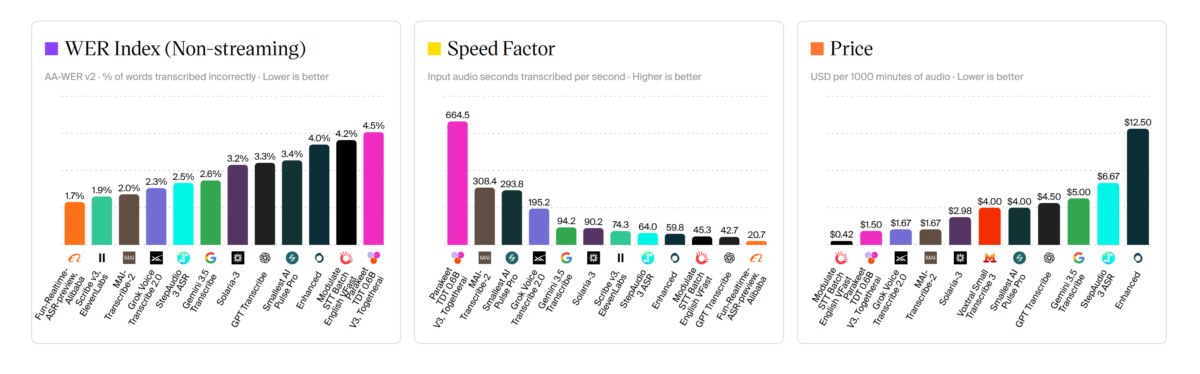
このベンチマークが測っているのは録音ファイルの単語誤りだけです。ElevenLabsが強調する話者分離やリアルタイムでの改善は、この第三者評価には含まれていない点に注意が必要です。
日本のEC事業者にとっての論点
結論から言うと、今回の発表でEC事業者が見るべきなのは精度の順位よりも、電話口のAIが「話し終わり」を判断する仕組みが変わった点です。以下の3つの論点は筆者の考察であり、ElevenLabsが公表した日本での導入事例ではありません。
1つ目は、番号や住所の聞き取りです。これまでの音声エージェントは、一定時間の無音を検知すると相手が話し終えたとみなす方式が主流でした。そのため、注文番号や電話番号をゆっくり読み上げている途中や、考えながら話している途中でAIが割り込んでしまいます。Scribe v3 Liveは音声だけでなく会話の文脈も見て話し終わりを判断するとされています。オランダで200万件超の家庭や企業に電力などを供給するEnecoの事前テストでは、郵便番号を1回で正しく認識できた割合が40%、番地は15%高まったと報告されています。注文番号、郵便番号、番地、電話番号を口頭で確認する場面は、楽天市場やYahoo!ショッピングの店舗が受ける電話問い合わせや、自社ECの電話注文でも日常的に発生します。
2つ目は、商品名やブランド名の誤認識です。Scribe v3では最大1,000語の用語をあらかじめ指定でき、Scribe v3 Liveでは数千語を登録できる用語ライブラリを、該当しそうな言葉が聞こえたときだけ参照する仕組みが用意されています。型番、ブランド名、成分名など、一般の辞書にない固有名詞が多いEC事業者ほど効果を確かめる価値があります。数字や日付の表記ルールを自然な文章で指定できる機能もあり、通話ログを受注システムに取り込みやすい形に整える用途が考えられます。
3つ目は、精度とコストの釣り合いです。通話録音を大量に文字起こしして応対品質を分析する用途では、わずかな精度差よりも速度と単価が効いてきます。うるチカラでも電話問い合わせのログ化コストやGemini 3.8 Liveの音声接客コストを取り上げてきましたが、リアルタイムの顧客対応は精度重視、録音の一括処理は単価重視と、用途ごとにモデルを分ける設計が現実的です。
今後の展望と初動アクション
今後は、音声認識の競争軸が単語の正確さから会話の自然さへ移っていくと考えられます。ElevenLabsは医療会話に最適化したScribe v3 LiveをElevenAgents向けに提供する方針も示しており、業種特化の流れも進みそうです。The Decoderによると、同社はNvidiaとの提携拡大やMcKinseyとの協業、Salesforce、IBM、Zendeskなどが既製の音声エージェントを提供するマーケットプレイスの整備も進めています。日本のEC事業者がまず取り組めることを3つ挙げます。
最初に、自社の電話問い合わせのうち、番号や住所の聞き取りで聞き返しが発生している割合を把握することです。録音が残っていれば、10〜20件を聞き直すだけでも傾向がつかめます。
次に、自社の通話録音を使った日本語での精度検証です。公表されている数値は多言語平均と欧州言語が中心で、日本語の改善幅や、日本の郵便番号、住所の読み上げでの精度は現時点で要確認です。商品名や型番を用語として登録した場合と登録しない場合を比べると、導入効果を見積もりやすくなります。
最後に、個人情報の扱いの確認です。電話音声には氏名、住所、場合によっては決済に関わる情報が含まれます。ElevenLabsは、リクエスト完了後に音声とテキストを削除するゼロリテンションモードや、法人向けにEU、インド、シンガポールの隔離環境を用意しているとしています。標準では米国で処理されるため、自社のプライバシーポリシーや委託先管理のルールと合うかを導入前に確認しておく必要があります。
まとめ
Scribe v3は102言語平均で誤認識を27%減らし、リアルタイム版のScribe v3 Liveは会話の文脈から話し終わりを判断することで、電話口のAIが相手をさえぎる問題に対処した音声認識モデルです。第三者ベンチマークでは精度が上位である一方、速度と価格では競合に劣る面もあります。日本のEC事業者は、日本語と自社の商品名での精度を自社データで確かめたうえで、リアルタイム対応と録音の一括処理でモデルを使い分ける姿勢が現実的です。
参考文献
- ElevenLabs公式ブログ「Introducing Scribe v3 and v3 Live, our most accurate speech to text models」
- The Decoder「ElevenLabs Scribe v3 Live uses conversational context to stop voice agents from cutting off callers mid-sentence」
- Artificial Analysis「ElevenLabs Speech to Text」ベンチマーク
- ElevenLabsドキュメント「Zero Retention Mode」
- ElevenLabsドキュメント「ElevenAgents overview」
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: The Decoder
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます