 投稿者 投稿日: カテゴリー AIニュース

ByteDanceは、学習3段階だけで作ったオープンなAIエージェント「Axion 1.0」を公開しました。
本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。2026年11月、TikTokの親会社であるByteDanceと米国の3大学の研究チームが、AIエージェント向けモデル「Axion 1.0」の論文と学習レシピを公開しました。注目点は、学習を「教師ありファインチューニング2回+強化学習1回」の3段階に絞り、約1万8,000件の学習データで、GPT-5.5など商用モデルに並ぶか一部上回るスコアを示したことです。AI開発は「工程を増やすほど強くなる」と考えられがちですが、Axion 1.0は「データの質こそが効く」という逆の主張を数字で示した点で、業界の議論を呼びそうです。
Axion 1.0とは何か、学習3段階で何が起きたのか
Axion 1.0とは、Web検索やPythonの実行を組み合わせて多段階の課題を自律的に解くことを目指した、オープンなAIエージェント用の基盤モデルのことです。arXivで公開された論文は2026年11月2日に投稿され、著者にはByteDanceの研究者に加え、デューク大学、メリーランド大学カレッジパーク校、バッファロー大学の研究者が名を連ねています。モデルは4B、9B、35B-A3B、122B-A10Bの4サイズで、主力の35Bと122BはそれぞれQwen系のMoEモデル(必要な部分だけを動かして計算量を抑える構造)をベースにしています。
学習工程はきわめてシンプルです。論文の要旨には「Axion 1.0 is trained in only three stages」と書かれており、具体的には次の流れです。第1段階では、数学・物理・化学・生物・コンピュータ科学の問題を難しく作り変えたデータで、Pythonだけを使って自力で推論する力を鍛えます。第2段階では、検索やWebページ閲覧、Python実行がないと解けない課題で、道具を使いこなす力を学ばせます。第3段階で、正答に報酬を与える強化学習(GRPOという手法)を行います。
一方で、近年の大規模モデル開発で一般的になっている中間学習(mid-training)、DPO(人の好みに沿わせる最適化)、オンポリシー蒸留(OPD)は使っていません。THE DECODERは、研究チームが成果の要因を学習ステップの多さではなく、丁寧に選別した学習データに求めていると報じています。
なぜ重要か、数字で見るAxion 1.0の実力
論文の比較表によると、Axion 1.0-122Bは難問ベンチマークのHLE(Humanity’s Last Exam)で59.0%を記録しました。同じ表でGPT-5.5は52.2%、Gemini 3.1 Proは51.4%で、これらを上回っています。一方、Claude Opus 5は63.6%と記載されており、すべての商用モデルを超えたわけではない点には注意が必要です。なおAxion 1.0のHLEスコアは、Hugging Faceへのアクセスを遮断した制限付き条件での値で、制限なしの条件では122Bが64.8%とされています。条件の違いがあるため、単純な横並び比較には慎重であるべきです。
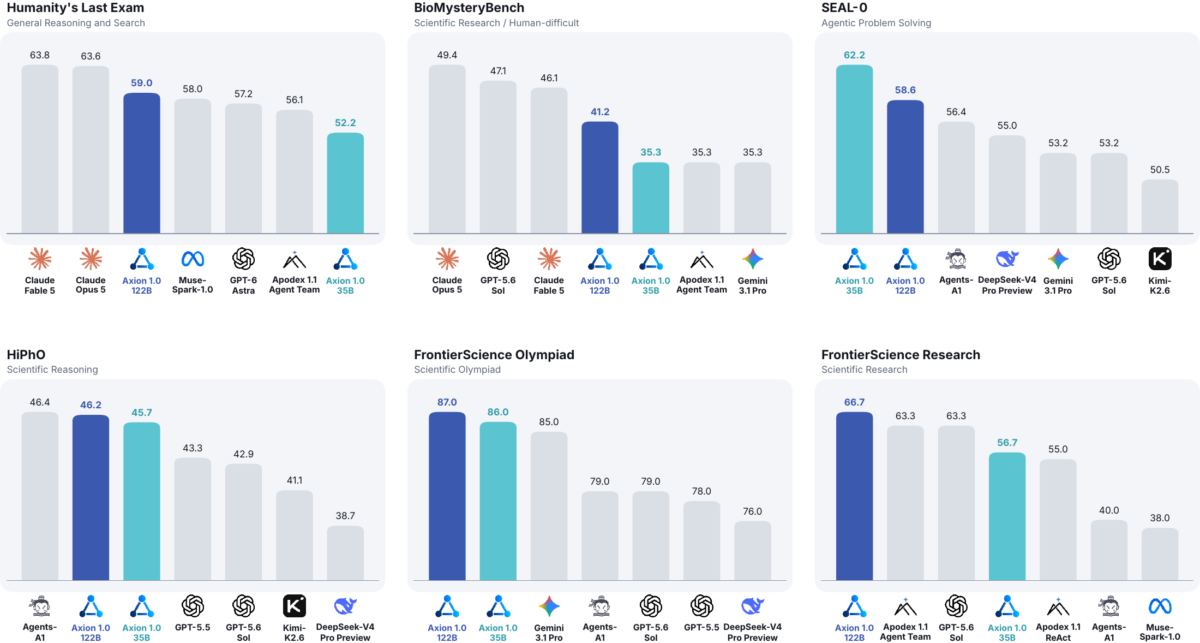
科学研究系の課題でも差が目立ちます。FrontierScienceのResearch部門では、122Bが66.7%、35Bが56.7%で、GPT-5.5の26.7%やGemini 3.1 Proの26.7%を大きく引き離しました。最新情報の検索精度を問うSEAL-0では、35Bが62.2%と122Bの58.6%を上回る結果も出ています。小さなモデルが大きなモデルを一部で逆転している点は、データ設計の効果を示す材料として興味深いところです。
学習コストの小ささも重要です。プロジェクトページによると、122Bモデルの教師あり学習2段階は32基のGPUで7時間30分、合計240GPU時間でした。強化学習を含めても122Bの学習は約1,000GPU時間規模とされています。学習データは約1万8,000件で、Hugging Faceのデータセットとして公開されています。35Bの再現用チェックポイントもHugging Faceで公開され、論文投稿者のコメントではApache 2.0ライセンスとされています(モデルカードでの確認は要確認)。
この研究の意義は、性能だけでなく再現性にあります。工程が増えるほど、どの工程が効いたのかが分からなくなり、他社や大学が追試することも難しくなります。Axion 1.0は工程を絞り、データ・コード・学習手順をまとめて公開することで、「強いエージェントは巨大資本でしか作れない」という前提に一石を投じた形です。
今後の動き、どこに注目すべきか
第一に、第三者による検証です。論文のスコアは3回実行した中での最高値とされ、比較対象の一部は他者や著者による評価値です。また、論文の表と再現用チェックポイントの数値にはわずかな差もあります。外部の研究者が公開レシピで同等の結果を再現できるかが、主張の信頼性を左右します。
第二に、データ中心の開発手法がどこまで広がるかです。約1万8,000件という規模は、大手でなくても十分に扱える量です。学習工程を減らし、良質なデータ作りに投資する流れが強まれば、中堅企業や研究機関が自社用途のエージェントを作るハードルは下がっていきます。
第三に、オープンモデル競争への影響です。比較表にはKimi-K2.6やDeepSeek-V4-Pro(Preview)など中国発のオープンモデルも並んでおり、Axion 1.0はHLEでこれらを上回っています。商用APIに頼らずに高性能なエージェントを動かす選択肢が増えることは、日本企業にとってもコストやデータ管理の面で検討材料になります。ただし、モデルを業務で使う場合は、ライセンス条件や安全性評価を自社で確認することが前提です。
まとめ
ByteDanceのAxion 1.0は、学習を3段階に絞り、約1万8,000件の厳選データでHLE 59.0%など商用モデルに迫る成績を示しました。全モデルを上回ったわけではなく、評価条件の違いや第三者検証の有無には注意が必要です。それでも「工程を増やすより、データの質を上げる」という方針をレシピごと公開した意味は大きく、今後のオープンなAIエージェント開発の基準になる可能性があります。
参考文献
- arXiv: Axion 1.0: Open Agent Foundation Models, Simplified
- Axion 1.0 プロジェクトページ
- Hugging Face Papers: Axion 1.0
- GitHub: bytedance/axion1_0
- THE DECODER: Bytedance argues most AI training phases are unnecessary
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: THE DECODER
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます