 投稿者 投稿日: カテゴリー AIニュース

GoogleがAIの探索戦略を過去ログだけで改善する手法を公開しました。
Google と Google DeepMind の研究チームが、AIエージェントの試行錯誤を効率化する手法「Dream-RSI」を発表しました。特徴は、モデル本体をいっさい再学習させず、過去の探索履歴を再生するだけで「次に何を試すか」の判断だけを鍛える点にあります。検証では、あるプログラム最適化タスクで必要な試行回数が550回から317回へと約42パーセント減りました。本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。AI自己改善の最新研究として、そして日々の運用改善に効く設計原則として、2つの視点から読み解きます。
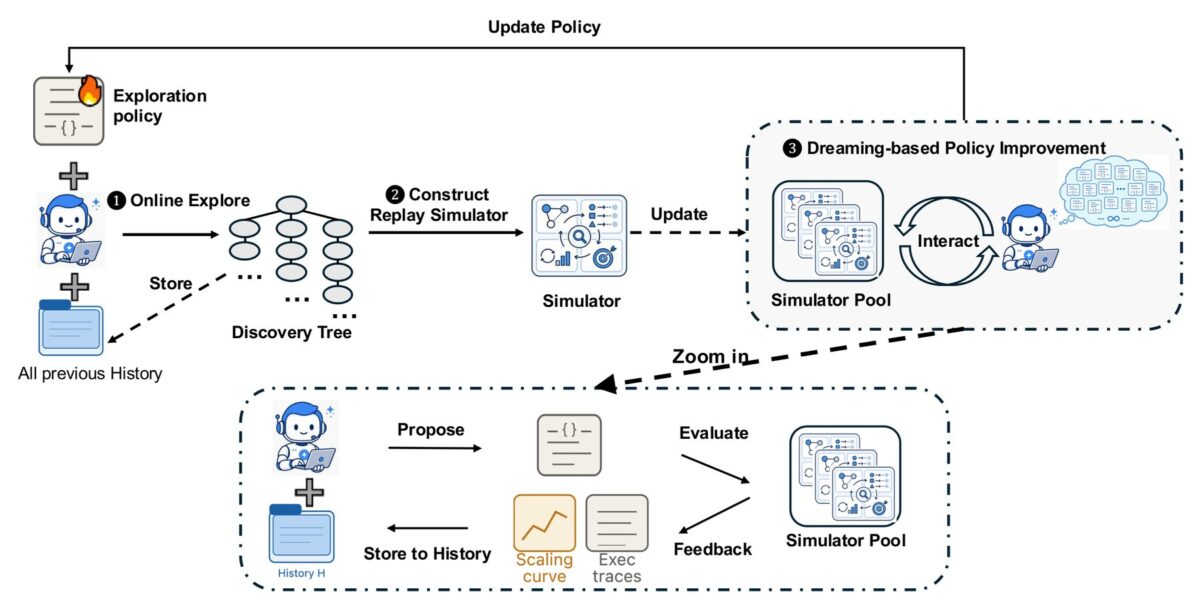
Dream-RSIとは、過去の探索履歴を再生して戦略だけを鍛える手法です
Dream-RSIとは、AIエージェントが過去に行った探索の記録を再生し、別の判断をしていたらどうなったかを検証することで、探索戦略そのものを改善する手法のことです。The Decoder が2026年9月19日に報じました。論文は「Dream-RSI: Recursive Self-Improvement through Evolving Worlds」としてarXivで公開され、コードもGitHubで配布されています。
自己改善型のAIエージェントは、解を提案し、評価し、結果から学び、また試すという手順を数千回単位で繰り返します。問題は、どの案を深追いし、どれを並行して試し、どれを捨てるかという「探索」の判断です。固定の戦略では同じ行き止まりに何度もぶつかり、探索中に戦略を変えようとすると、その戦略が良いか確かめるためだけに長く高価な実行を繰り返すことになります。
研究チームが提案したのは、完了した探索の記録を再利用して、すでに踏破した範囲の中で別の戦略を試す方法です。結果はすでに計算済みなので、モデルを呼び直したり評価をやり直したりする必要がありません。エージェントは数千通りの戦略を記録上で「夢想」し、品質とコストと並列計算の使い方で最も良かったものを選んでから、実際の探索に投入します。研究チームはこれを、一度歩いた街の地図を頭の中に持てば、実際に歩き直さなくても別ルートを計画できることに例えています。
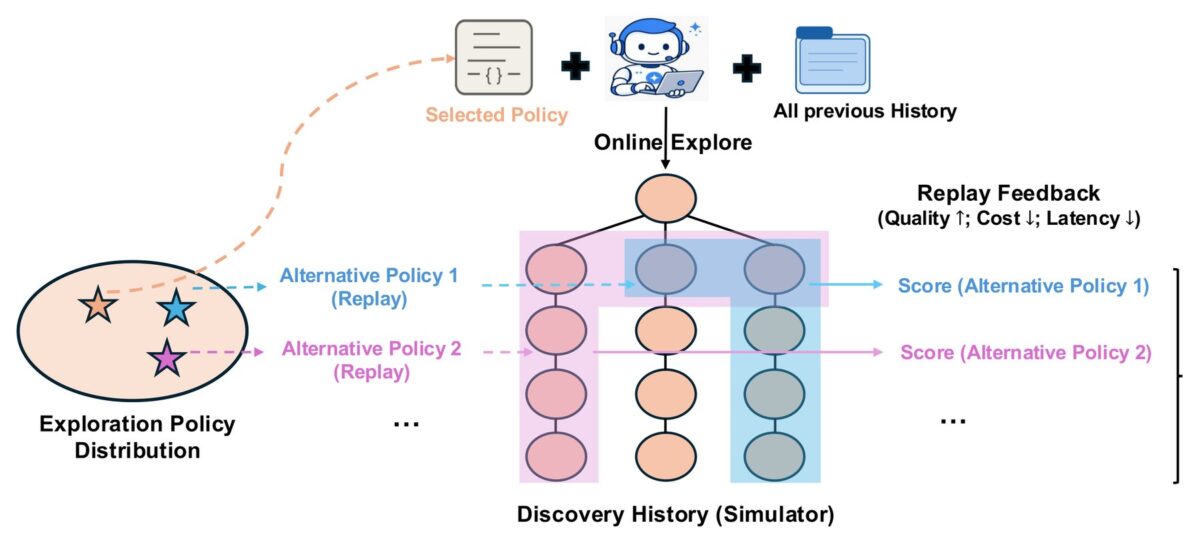
重要なのは、この循環で変わるのが探索戦略だけであり、解を生成するモデル自体は手つかずのままという点です。モデルの重みを触らずに再帰的自己改善を成立させた、という位置づけになります。
探索550回が317回に、GPUカーネルでは最大2.43倍の効率
検証では、試行回数が550回から317回へ減り、競合手法と比べると約160分の1の呼び出し回数で同等の成果に届きました。研究チームは Gemini 3.1 Pro と Gemini 3.7 Flash を使い、3領域8タスクで比較しています。比較対象は、同じ初期条件で探索戦略だけを固定した版です。
ひとつのタスクは、ゲノミクスや金融でよく使われる統計計算について、可能な限り高速なプログラムを書かせるものでした。Dream-RSIが生み出したプログラムは、確立されたライブラリである sklearn と glmnet を、6つのテストデータセットすべてで上回りました。Gemini 3.1 Pro を使った場合、平均実行時間は3,587ミリ秒から2,931ミリ秒へと約18パーセント短縮され、試行回数は550回から317回に減りました。競合手法の SimpleTES が51,200回の実行を要したのに対し、Dream-RSIは317回で済んでいます。
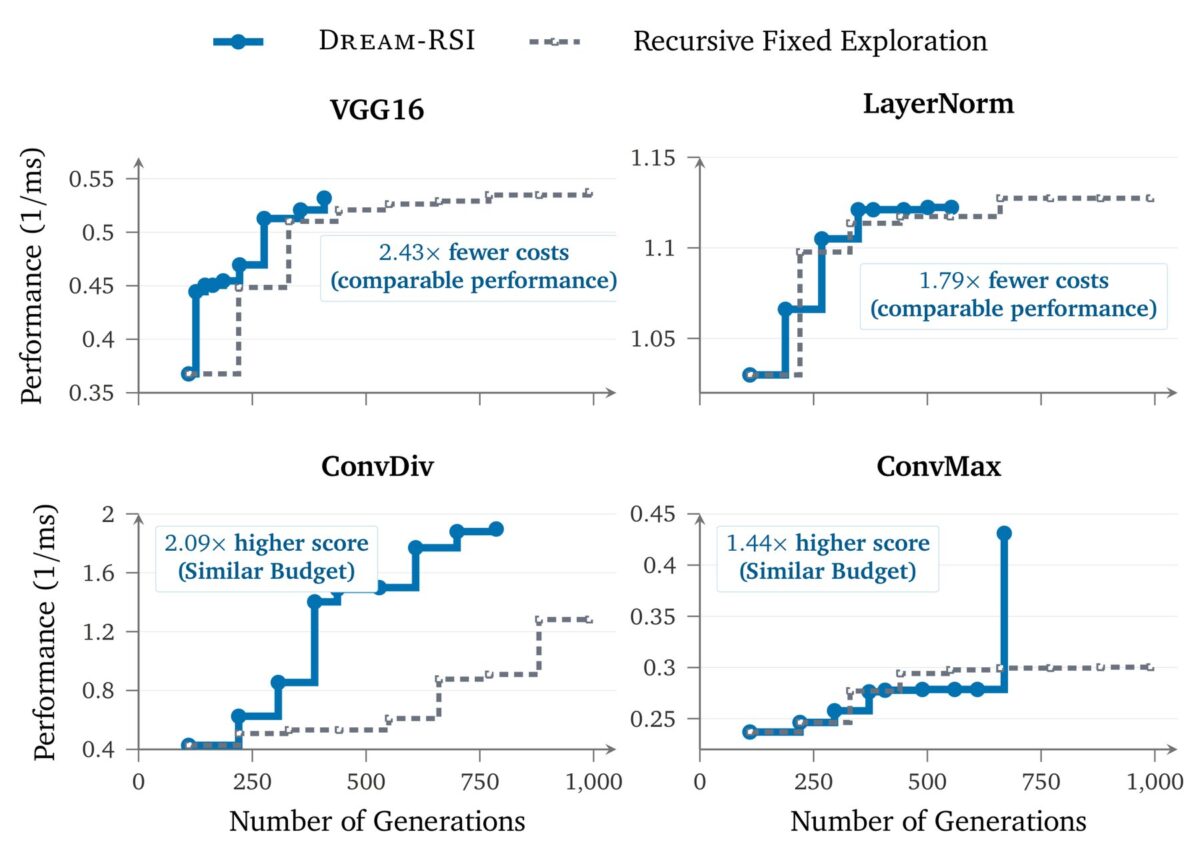
同じ傾向は数理最適化とGPUカーネルの高速化でも確認されました。GPU関連の2タスクでは、世代数を最大2.43分の1に減らしながら同等の性能に到達し、別の2タスクでは同じ計算予算のまま最大2.09倍の性能を出しています。
興味深いのは追加分析の結果です。研究チームは、履歴を再生する代わりに「どこを探せばよいか」という指示文に凝縮してエージェントへ渡す方法も試しました。あるGPUタスクでは、この指示を与えた版のほうが、与えなかった版より成績が悪くなりました。指示が具体的すぎると探索範囲を狭めすぎ、幅広い手法を試せなくなるためだと研究チームは考察しています。学習された戦略の挙動も示唆的で、性能が伸びている間は試行回数を絞り、伸びが止まると再び試行を増やし、それが次の改善につながっていました。
日本のEC事業者が持ち帰れるのは「記録を捨てない」という設計原則
Dream-RSIは研究成果であり、明日から店舗運営に導入できる製品ではありません。ただし、この手法が成立した前提条件は、EC運営の改善サイクルにそのまま置き換えられます。持ち帰れる論点は3つです。
第1に、試行と結果をセットで記録に残すことです。Dream-RSIが数千通りの戦略を無料で検証できたのは、過去の試行とその結果がすべて保存されていたからでした。楽天市場のRPP入札変更、Amazonの広告キーワード追加、商品名の書き換えといった施策は、多くの店舗で「変更した」という事実だけが残り、いつ何をどう変え、その後の指標がどう動いたかが対になって残っていません。記録がなければ、後から別の打ち手を机上で検証することもできません。まずは変更日、変更内容、変更前後14日間の主要指標を1行で残す運用から始める価値があります。
第2に、指示を具体化しすぎないことです。過去の履歴を細かい指示文に凝縮したほうが成績が落ちたという結果は、運用マニュアルやプロンプトを細かく縛りすぎると改善が止まる、という現場の実感と重なります。Googleが別に公開した WikiSkill のように失敗と成功を指示として蓄積する方式もありますが、答えが決まっていない探索的な課題では、余白を残したほうが伸びる場面があるということです。
第3に、停滞したら試行本数を増やすことです。学習された戦略は、成果が伸びている局面では試行を減らして効率を取り、停滞すると試行を増やして突破口を探しました。売上が伸びている施策は触らず、指標が横ばいになった商品カテゴリでこそテストの本数を増やす、という配分に読み替えられます。AIエージェントに業務を任せる流れそのものは、GPT-6 Astraが自律で事業運営を担ったベンチマークやエージェント監視の議論でも進んでおり、記録の取り方が後から効いてきます。
今後の動き
再帰的自己改善の研究は、ここ数か月で急速に注目度を上げています。Google DeepMind は2025年にAlphaEvolveを発表し、Gemini Flash が案を出し、Gemini Pro が分析し、進化的アルゴリズムが選別するという仕組みを示していました。Dream-RSI はその一段上、探索戦略そのものを最適化する層にあたります。Meta も、改善の仕組み自体をエージェントに書き換えさせる方向を進めています。
モデルの重みを触らずに性能が上がるという点は、コスト面でも見逃せません。再学習なしで改善が積み上がるなら、最新モデルへの乗り換え頻度を上げなくても運用の質を高められる可能性があります。ただし現時点では限られたタスクでの検証結果であり、一般の業務タスクへどこまで一般化できるかは要確認です。コードが公開されているため、追試の結果が数週間のうちに出てくると見られます。
まとめ
Dream-RSIは、AIエージェントが過去の探索記録を再生することで、モデルを再学習させずに探索戦略だけを改善する手法です。試行回数は550回から317回へ減り、GPUタスクでは世代数を最大2.43分の1に圧縮しました。EC事業者にとっての示唆は、施策の試行と結果を対で記録に残すこと、指示で縛りすぎないこと、停滞時に試行本数を増やすことの3点です。技術そのものより、改善サイクルの設計思想として受け取るのが実務的です。
参考文献
- The Decoder|Google Deepmind’s Dream-RSI helps AI agents improve by “dreaming” about past attempts
- arXiv|Dream-RSI: Recursive Self-Improvement through Evolving Worlds
- GitHub|zhengkid/Dream-RSI
- The Decoder|AlphaEvolve is Google Deepmind’s new AI system that autonomously creates better algorithms
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: The Decoder
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます