 投稿者 投稿日: カテゴリー AIニュース

Vals AI は2026年10月9日、AIエージェントのチーム化が費用1.8〜5.1倍で効果は限定的と発表しました。
複数のAIエージェントを並列に走らせる「チーム構成」は、単体のエージェントより本当に成果が出るのか。AI評価企業のVals AIが2026年10月9日に公開した検証では、チーム化によってコストは1.8倍から5.1倍に増えた一方、統計的に意味のある品質向上が確認できたのは4つの設定のうち1つだけでした。本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が、この検証結果と日本のEC事業者が自動化設計で押さえるべき3つの論点を解説します。
Vals AIの検証で分かったこと:50本のWebアプリ開発で単体とチームを比較
結論は、チーム化で有意に点数が伸びたのは「GPT-6 Sol の中程度の推論設定」だけで、残り3設定は費用だけが増えたという内容です。The Decoderが10月11日に報じたこの検証は、Vals AI のベンチマーク「Vibe Code Bench」から50本のWebアプリ開発課題を抜き出し、OpenAI の GPT-6 Sol と Anthropic の Claude Opus 5.5 を、それぞれ単体エージェントとチーム構成で走らせたものです。チームでは、リーダー役のエージェントが最大5体のサブエージェントに同時に作業を振り分け、サブエージェントはさらに下位のエージェントを起こせない設計でした。
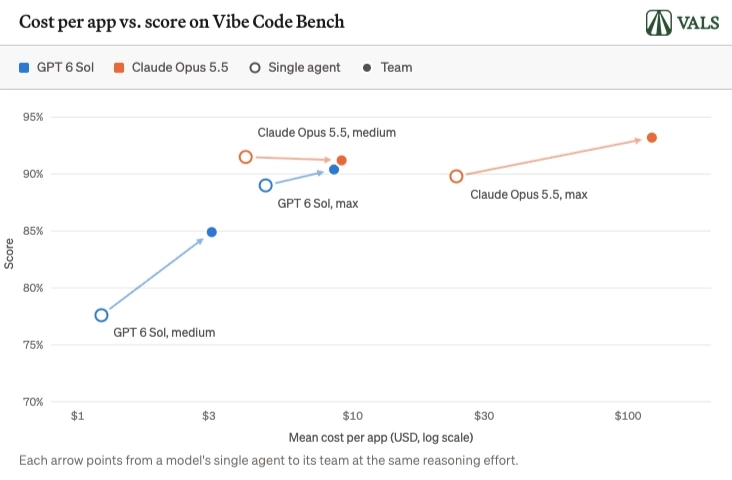
数字を見ると、GPT-6 Sol の中程度の推論設定ではチーム化で正答率が77.6%から84.9%へ7.3ポイント上がり、統計的にも有意(p値0.005)でした。ところが同じ GPT-6 Sol でも推論を最大にすると、チーム化の上積みは1.4ポイントにとどまり有意ではありません。Claude Opus 5.5 は中程度の設定でチーム化すると0.3ポイント下がり、最大設定では3.4ポイント上がったものの、どちらも偶然の範囲と判定されています。
費用はすべての設定でチームの方が高く、GPT-6 Sol の中程度で2.5倍(1課題あたり1.22ドルが3.07ドル)、最大設定で1.8倍、Claude Opus 5.5 の中程度で2.2倍、最大設定では5.1倍(23.77ドルが122ドル)に膨らみました。Claude Opus 5.5 の最大設定チームは、1つのアプリを作るのにサブエージェントだけで中央値2億2,400万トークン(キャッシュ込み)を消費し、単体の5,500万トークンの4倍以上でした。処理時間も最大設定では単体の74.7分に対しチームは174.1分と、速くなるどころか2倍以上かかっています。
なぜチームにしても伸びないのか:調整コストと「推論を強める」という代替手段
チーム化が効かない最大の理由は、エージェント同士の作業を統合し検証する「調整コスト」が、分担による効率化を打ち消すからです。Vals AI の観察では、Claude Opus 5.5 のチームは最大設定で平均6.8体のサブエージェントを起こし、50本中40本で共有の仕様書をまず作成してから作業を順番に流していました。実行時間の3分の2は最初のデプロイ後のテストと修正に費やされ、中央値で67.8エージェント分がテストに使われています。丁寧ではあるものの、その丁寧さが費用5.1倍の正体です。
もう1つの示唆は、チームを組む前に「単体のまま推論の強度を上げる」選択肢を比較すべきだという点です。GPT-6 Sol では、中程度設定のチーム(84.9%、3.07ドル)より、最大設定の単体(89.0%、4.82ドル)の方が高得点でした。Claude Opus 5.5 に至っては、最も安い中程度の単体(91.5%、4.08ドル)が、最も高い最大設定のチーム(93.2%、122ドル)とほぼ同じ水準です。Vals AI 自身も「チームが割に合うかはモデル・課題・予算次第で、推論強度を上げる方が良い場合がある」とまとめています。
この結果は、2026年9月に OpenAI の Codex 開発者 Eric Provencher が「並列サブエージェントは3体以上でほぼ確実にトークンを浪費する」と警告した内容とも整合します。うるチカラでもAIエージェント並列3体以上は逆効果|2万ドル浪費とEC運用3論点で取り上げましたが、今回はベンチマークの実測値で裏付けが加わった形です。なお Anthropic が Claude Opus 5.5 のシステムカードで示した社内検証では、エージェント1体から10体に増やすと知識ベース課題のスコアが0.53から0.70に伸びたものの、100体にしても0.74と伸びは頭打ちになっており、「10体を超えると効果が薄れる」という傾向は一致しています。
日本のEC事業者が自動化設計で押さえる3つの論点
論点の1つ目は、EC業務のエージェント化で「何体必要か」を決める前に、1体の推論強度を上げた場合の精度と費用を先に測ることです。商品説明文の量産、レビュー返信の下書き、受注データの異常検知といった店舗業務は、Vibe Code Bench のWebアプリ開発より課題の独立性が低く、1体で順番に処理した方が整合性を保ちやすいケースが大半です。推論強度の切り替えは ChatGPT・Claude・Gemini のいずれもAPI側の設定1つで済み、チーム構成を組むより検証が早く終わります。
2つ目は、チーム化が効く条件を「分割できる作業が長く続き、各パーツが独立している業務」に限定することです。Vals AI は今後の候補として、大規模なコードベース、広い調査課題、多数の文書にまたがる分析を挙げています。EC現場で言えば、数千SKUの商品マスタをカテゴリ別に分けて同時に整形する、競合100店舗の商品ページを分担して要約する、といった用途です。逆に、1つの商品ページを複数体で同時に編集するような設計は、統合コストの方が重くなります。
3つ目は、費用の上限をエージェント設計の段階で固定することです。今回の検証では、同じモデルでも設定の違いだけで1課題あたり4ドルから122ドルまで30倍の開きが出ました。月に数百から数千回走る店舗の自動化で、この差を放置すると月額が数十万円単位で変わります。1実行あたりのトークン上限とサブエージェント数の上限を先に決め、超えたら止まる設計にしておくのが、2026年10月時点で現実的な守り方です。
まとめ
Vals AI の検証は、AIエージェントのチーム化が費用1.8〜5.1倍に対して、有意な品質向上は4設定中1つだけだったことを示しました。EC事業者がとるべき姿勢は「まず1体の推論強度を上げて測る、チーム化は独立作業が長く続く業務に限る、費用上限を先に固定する」の3点です。並列化は手段であって目的ではなく、成果と費用の実測で決める段階に入っています。
参考文献
- Vals AI・Do Agent Teams Pay Off? A Case Study on Vibe Code Bench
- The Decoder・AI agent teams waste massive tokens for barely measurable quality gains, research finds
- Anthropic・Claude Opus 5.5 System Card
- The Decoder・AI agent swarms are a massive waste of tokens with zero quality gain, says OpenAI Codex developer
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: The Decoder
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます