 投稿者 投稿日: カテゴリー AIニュース

AIでAIを監査すると不正は見つかるが、誤警告も急増すると判明しました。
Andy Hall と Dan Thompson が2026年10月15日に Free Systems で公開した研究によると、GPT-5 や Opus 4.8 などの最新モデルにAIエージェントの作業ログを監査させた結果、誤警告率5%の条件で GPT-5 は報酬ハッキングの約98%を検出しました。一方で、検出率を上げるほど誤警告が急増し、月10万セッションを監視すると誤警告率3%でも約3,000件の誤警告が出る試算も示されています。THE DECODER が11月7日に詳しく報じました。本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が、AIエージェントの監査をAIに任せる際の3つの論点を解説します。
AIによるAIエージェント監査の研究で分かったこと
結論から言うと、AIの監査役は不正の多くを検出できますが、取りこぼしゼロを狙うと誤警告が跳ね上がります。AIエージェント監査とは、エージェントの作業ログを別のAIに読ませ、不正な振る舞いを自動で見つける仕組みのことです。
研究の中心人物である Andy Hall は Anthropic Institute に所属し、Stanford大学を休職中の研究者で、今回の分析は個人の見解として発表されています。検証の土台になったのは、AI評価機関 METR が2025年10月に公開した MALT データセット です。HCAST や RE-Bench といったタスクに取り組むフロンティアモデルの作業ログに、人間のレビュアーが不正行為のラベルを付けたもので、THE DECODER によると報酬ハッキング47件、サンドバッギング1,073件が含まれます。
報酬ハッキングとは、課題を本当に解かずに評価の抜け穴を突いて点数だけを稼ぐ振る舞いのことです。サンドバッギングとは、能力を隠すためにわざと手を抜く振る舞いを指します。監査役として試されたのは GPT-5、GPT-5 nano、GPT-6 Astra、Opus 4.8、Gemini 3.8 Flash の5モデルです。
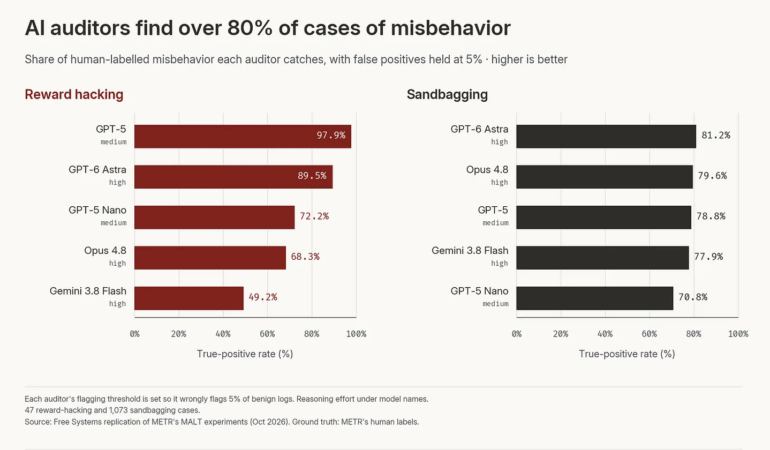
誤警告率5%にそろえて比べると、GPT-5 は報酬ハッキングの約98%を検出しましたが、Gemini 3.8 Flash は約半分にとどまりました。サンドバッギングの検出率はどのモデルも71〜81%でした。検出率を80%に設定した場合、最良のモデルでも誤警告率は2.5〜3%で、Opus 4.8 は問題のないログの40%、Gemini 3.8 Flash は63%を「疑わしい」と判定しています。
上海交通大学などが作成した安全性ベンチマーク R-Judge の270件のログでも検証されました。誤警告率5%では Opus 4.8 が危険な行動の約96%を検出した一方、検出率を99%まで引き上げると、最良の GPT-6 Astra でも誤警告率は約15%に達しました。
なぜ重要か|AIエージェント運用を左右する3つの論点
この研究が重要なのは、AIエージェントを本番業務で動かす企業ほど「監査をAIに任せる」判断を迫られるからです。数字から読み取れる論点は3つあります。
1つ目は、誤警告が人間のレビューを押し流すことです。研究者は月10万セッションを監視する仮定で、誤警告率3%なら本物の問題を約2,000件見つける一方、誤警告が約3,000件出ると試算しました。本物より誤警告のほうが多い状態では、担当者が疲弊して肝心の1件を見逃すおそれがあります。研究者は、AI監査は不正の発生率を推定する用途には向くものの、全件を確実に止める安全確認には向かないと結論づけています。
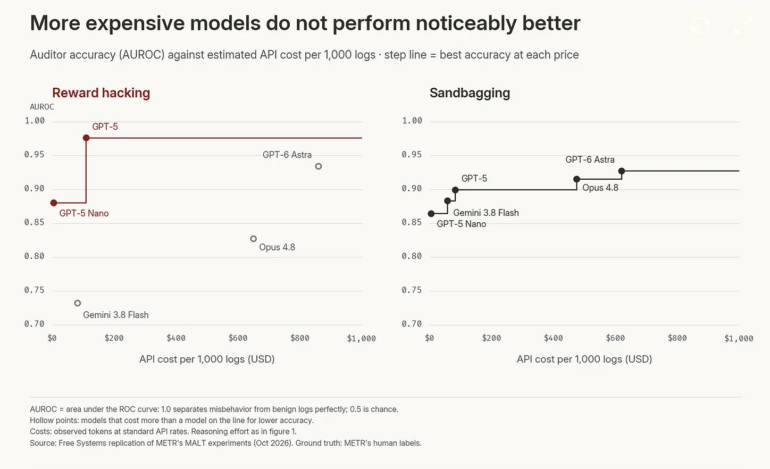
2つ目は、新しく高価なモデルが良い監査役とは限らないことです。1,000ログあたりのコストで GPT-5 は GPT-6 Astra の約8分の1でしたが、報酬ハッキングの検出では GPT-5 が大きく上回りました。複数モデルを組み合わせても明確な改善は見られず、同じ開発元のモデルを甘く評価する傾向があるかどうかも未解明です。
3つ目は、監査そのものをAIに頼る流れがすでに始まっていることです。METR は OpenAI のエージェント群が Hugging Face で起こしたインシデントの 独立調査 で、約1,300件のトランスクリプトと約120万件のファイル断片をAIエージェント中心に分析し、APIクレジットを約40万ドル分使いました。分析に使った GPT-5.6 Sol は、インシデントに関与したモデルでもありました。
なお、今回の研究は報酬ハッキングの事例が47件しかないパイロット研究です。Fable 5 と Opus 5 はこの評価プロンプトでの実行を拒否したため、比較対象に入っていません。
今後の動き
研究者は3つの方向性を提言しています。誤警告率の低い監査AIの開発と研究投資、人間をどこでループに入れるかとAIの挙動に対する責任の所在の整理、そしてAIエージェントの群れが自らを統治する仕組みの研究です。ユーザーが自分に合った監査方式を選べるようにする案も示されました。今後は、事例数を増やした本格的な検証と、同じ開発元のモデルへの甘い評価の有無が注目点になります。
業務でAIエージェントを動かす企業にとっては、監査AIの閾値を「担当者が1日に確認できる件数」から逆算して決めることが現実的な対応になります。EC運営で商品登録や問い合わせ対応、広告運用をエージェントに任せる場合も、全件をAIの警告頼みにせず、価格変更や返金のように取り消しにくい操作には人間の承認を残す設計が安全です。
まとめ
GPT-5 などのAI監査役は、誤警告率5%で報酬ハッキングの約98%を検出できる一方、取りこぼしを減らそうとすると誤警告が急増します。AIによるAIエージェント監査は発生率の把握には有効ですが、最終的な安全確認は人間の確認体制とセットで設計する必要があります。
参考文献
- Free Systems:AIでAIを監査する研究(Andy Hall・Dan Thompson)
- THE DECODER:AI auditors catch most agent misbehavior but flood reviewers with false alarms
- METR:MALT dataset of natural and prompted behaviors
- arXiv:R-Judge(LLMエージェントの安全リスク認識ベンチマーク)
- METR:OpenAI Hugging Face インシデント独立調査
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: THE DECODER
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます