 投稿者 投稿日: カテゴリー AIニュース

OpenAIは2026年7月29日、API設定2つでARC-AGI-3のスコアが3倍になったと公表しました。
同じモデル、同じベンチマークでも、測定側の設定次第で13.3パーセントが38.3パーセントに変わりました。しかも出力トークンは6分の1に減っています。AIモデル比較の数字がどこまで実力を表しているのかという問題は、商品説明の一括生成や問い合わせ返信にAIを組み込んでいる日本のEC事業者にとって、来月のAPI請求額と品質の両方に直結します。本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。
13.3パーセントが38.3パーセントに:何が変わったのか
結論から言えば、変わったのはモデルではなく、モデルの外側にある2つのAPI設定です。OpenAIの公開レポートによると、ARC-AGI-3の公開タスクセットで、公式の測定用プログラムを使ったGPT-5.6 Solのスコアは13.3パーセントでした。ところが、ChatGPTやCodexで実際に使っている2つの設定を有効にしたところ、同じモデルが38.3パーセントを記録しています。
有効にしたのは、推論内容の保持(retained reasoning)と、文脈の圧縮(compaction)の2つです。公式の測定用プログラムでは、1手ごとにモデルの内部的な思考が破棄され、履歴が長くなると古い部分から順に切り落とされる方式が採られていました。つまりモデルは毎回ゲームのルールを一から考え直し、しかも自分が何をしたかも忘れていく状態で解いていたわけです。この2点を実運用と同じ設定に変えると、スコアが約3倍になり、出力トークンは6分の1に減りました。
数字の意味を補足しておきます。ARC-AGI-3のスコアは、人間の操作効率と比べた相対値(RHAE)で表され、OpenAIは公開されている人間のプレイログから、テスト参加者の平均を48パーセントと推定しています。モデルは自分の得点方法を知らされず、途中で点数を見ることもできません。一方、ARC Prizeの公式結果ページに載っているGPT-5.6 Solの検証済みスコアは、最上位の推論設定で公開セット13.33パーセント、準非公開セット7.78パーセントです。ARC-AGI-1では96.5パーセント、ARC-AGI-2では92.5パーセントを取っているモデルが、ARC-AGI-3では1桁台に落ちていたわけで、OpenAI側が疑問を持った理由はここにあります。
ARC側の立場と、それでも残る比較の難しさ
ARC Prizeが意図的に汎用の測定用プログラムを使っているのには理由があります。OpenAIも認めているとおり、単純な測定環境のほうがモデルの弱点が見えやすく、モデル同士の比較が公平になるという考え方です。商用の開発者は各モデルの特性に合わせて外側の仕組みを最適化しますから、そこを揃えないと「モデルの差」ではなく「作り込みの差」を測ってしまいます。ARC Prizeは、将来のAGIは外部の助けなしに新しい課題を解けるべきだという立場を取っています。
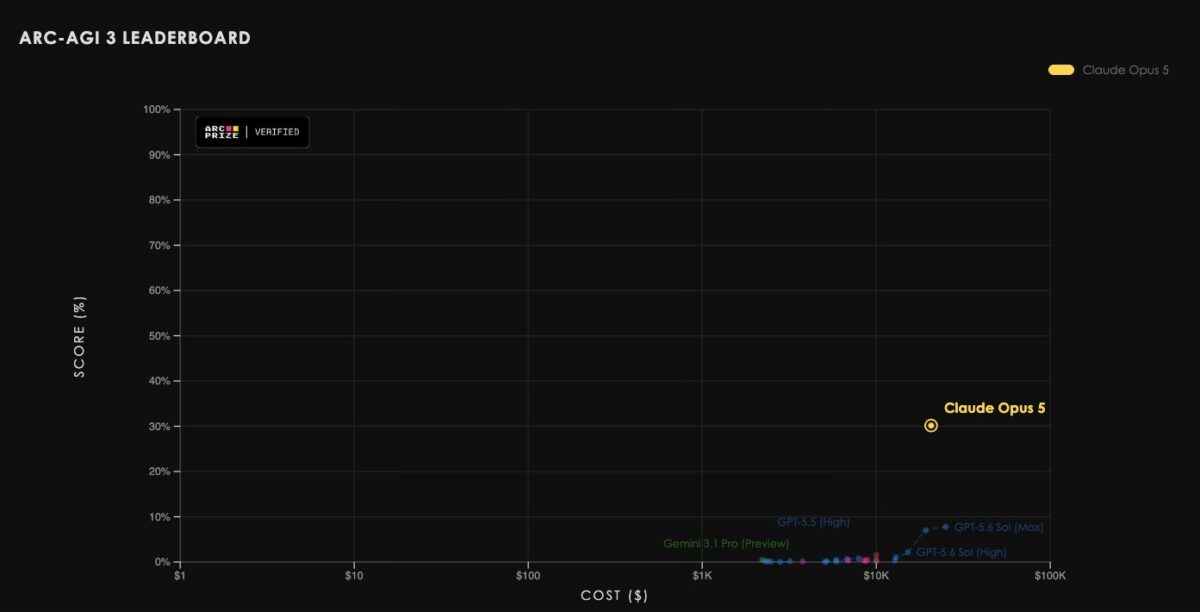
この文脈で押さえておきたいのが、直近の順位です。The Decoderによると、Claude Opus 5がARC-AGI-3で30.2パーセントを記録し、それまでの記録だったGPT-5.6 Sol(Max)の7.8パーセントを約4倍上回りました。ARC Prizeはこれを論理的推論力の向上によるものだと説明しています。ただし同記事は、対話型パズルの私設ベンチマークWitnessではOpus 5が43.4という結果で、Kimi K3やFable 5と統計的に並ぶ水準にとどまったという別の検証も紹介しています。
つまり、7.8パーセントという公式値、38.3パーセントという設定変更後の値、30.2パーセントという別モデルの公式値が、同じベンチマーク名のもとで並んでいる状態です。どれかが嘘というわけではなく、測っている条件が違います。AIモデル比較の記事や資料を読むときに、この前提を外すと判断を誤ります。
日本のEC事業者にとっての3つの盲点
ここからがEC運営の話です。すでに商品説明の生成や問い合わせ返信の下書きにAIを使っている店舗ほど、次の3点が効いてきます。
第一に、ベンダー発表の順位表をそのまま採用の根拠にしないことです。今回明らかになったのは、「モデルの実力」と称されている数字が、実際には推論の保持方法や文脈の切り方といった設定を含んだ束であるという点です。楽天市場の商品説明を1,000件リライトする、Amazonの問い合わせに1日200件返す、といった自社の作業に置き換えたとき、順位表の差がそのまま出るとは限りません。過去にも低コスト・高速モデルの比較やOpus 5・Grok 4.6・GPT-5.6の使い分けを扱いましたが、結局は自社データで測るのが最短です。
第二に、出力トークンが6分の1になったという事実を、そのままコスト話として読むことです。生成AIのAPI料金は入力と出力のトークン数で決まります。設定の変更だけで出力量が6分の1になったのなら、同じ処理の請求額が下がる可能性があります。特に商品数の多い店舗で効きます。Opus 5の128kトークン出力を使った商品説明の一括生成のような長文一括処理では、トークン量の差が月額にそのまま乗ってきます。ただし今回の6分の1はARC-AGI-3という特定タスクでの結果ですので、自社の処理で同じ比率になるかは要確認です。
第三に、長時間走る処理の記憶設計です。公式の測定用プログラムが採っていた「古い履歴から切り落とす」方式は、実は自社ツールでもよく採られるやり方です。文脈の上限に当たったので前を捨てる、という素朴な実装です。今回の検証は、その素朴な実装が精度と速度の両方を落としうることを示しました。過去記事のコンテキストエンジニアリングの考え方や、モデルと業務側の仕組みを分けるという設計思想と地続きの論点です。
初動アクション:自社で測り直すための4手順
まず、いま使っているAPIの呼び出し方式を確認します。OpenAIは公開レポートの推奨として、旧来のChat Completions APIではなくResponses APIを使い、推論を保持し、圧縮を使うことを挙げています。自社の実装が古い方式のままなら、まずここが改善の余地です。
次に、自社の実作業を10件から30件だけ切り出して、設定を変える前と後で同じ入力を流します。比べるのは3つで足ります。出力の品質、出力トークン数、1件あたりの所要時間です。順位表ではなく自社の伝票で判断するという考え方です。
3番目に、長い処理で履歴をどう扱っているかを点検します。文脈が上限に近づいたときに古い部分を単純に捨てているなら、要約して引き継ぐ方式に変える余地があります。商品説明の一括生成のように同じルールを何百件も適用する処理では、ルールを覚え続けられるかどうかが品質のばらつきに直結します。
最後に、社内の意思決定文書から「ベンチマーク○位だから採用」という書き方を外します。代わりに「自社の作業Xで品質Y、1件あたりZ円だから採用」と書きます。今回の件は、その言い換えが必要な理由を1つの数字で示してくれました。なお独立検証の結果はモデルによって振れ幅がありますので、特定モデルが常に最良と決め打ちしない運用が安全です。
まとめ
同じモデルでも、推論の保持と文脈の圧縮という2つの設定でARC-AGI-3のスコアは13.3パーセントから38.3パーセントに、出力トークンは6分の1に変わりました。AIモデル比較の数字はモデル単体ではなく測定条件込みの数字です。日本のEC事業者がとるべきスタンスは、順位表を参考程度に置き、自社の商品数と作業内容で品質とトークン量を測り直すことです。
参考文献
- OpenAI|How enabling two settings tripled our scores on the ARC-AGI-3 benchmark
- ARC Prize|GPT-5.6 Sol – ARC-AGI Results
- OpenAI API Docs|Compaction
- ARC Prize|Analyzing GPT-5.5 & Opus 4.7 with ARC-AGI-3
- The Decoder|Anthropic’s Opus 5 blows past Fable 5 and GPT-5.6 Sol on ARC-AGI-3
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: OpenAI
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます