 投稿者 投稿日: カテゴリー AIニュース

NVIDIA は2026年9月、熟練者の配分判断を学習したAIを供給網に導入しました。
NVIDIA と Palantir が2026年9月10日に公表したのは、新しい対話AIではありませんでした。毎週くり返される「限られた部品を、どの工場に、どれだけ回すか」という地味な配分判断を、AIに覚えさせる取り組みです。これはEC事業者が毎週やっている在庫配分や発注量の決定と、構造がほとんど同じ問題です。しかも成果として提示された数字が、割当判断の正答率86.7%という具体的なものでした。本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。
130万点の部品を毎週配り直す、NVIDIAの配分問題
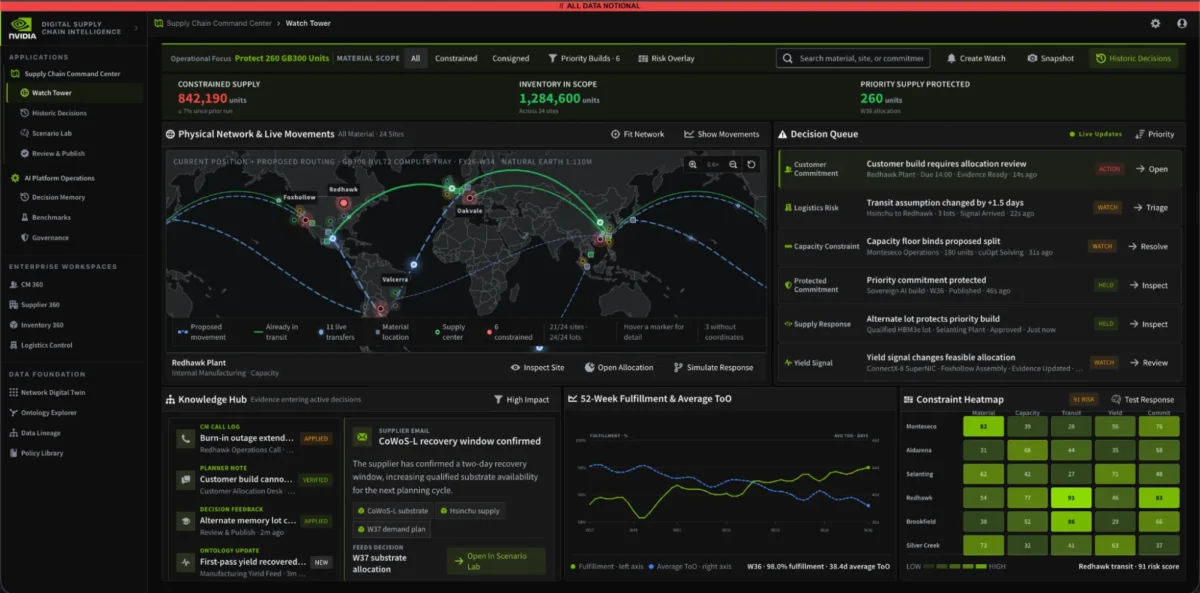
今回AIに任されたのは需要予測ではなく、限られた在庫を誰に回すかという配分判断です。NVIDIA Newsroomの発表によると、両社はPalantir Foundryと AIP にNVIDIA Nemotronのオープンモデルを組み込んだAIスタックを構築し、まず NVIDIA 自身の供給網へ展開しました。
規模の前提を押さえておきます。NVIDIA Technical Blogによれば、Vera Rubin ラック1台に使われる部品は130万点、サプライヤーは数千社に及びます。GB200 NVL72 のコンピュートトレイは1枚あたり Grace CPU 2個、Blackwell GPU 4個、HBM3e 32スタックを必要とし、それがラック1台に18枚入ります。Vera Rubin 向けの供給網は Grace Blackwell 世代の2倍の規模になったとも書かれています。
厄介なのは、委託製造の工場が全部品の到着を待たないと組立を始められない点です。早く届いた部品は、遅れている部品をただ待つことになります。NVIDIA はこの「材料を受け取ってから出荷するまで」を Time of Ownership と呼び、この時間を最小化する形で毎週の配分計画を手作業で組み直してきました。
そこで Palantir の Ontology に材料・製造拠点・コミット・生産能力・実績・定性的な情報を集約し、GPU最適化ライブラリのNVIDIA cuOptが混合整数線形計画として解く構成にしました。cuOpt は配分結果だけでなく、今週の数字を押さえ込んだのがメモリ供給ではなく台湾の生産能力だった、といった効いている制約まで返します。Jensen Huang は「サプライチェーンは物理経済のオペレーティングシステムだ」と述べています。
数式より人が強かった理由と、86.7%という数字
興味深いのは、過去の配分判断を検証したところ、人間のプランナーが最適化ソルバーを上回っていたことです。理由はその週にやり取りしたメール、重要地域の気象予報、進行中の地政学リスク、サプライヤーとの面談記録など、ソルバーが見られない情報を人が使っていたからだと説明されています。
そこで両社は、判断そのものではなく判断のプロセスを記録する運用に切り替えました。どういう配分にしたか、その根拠は何か、どうなると見込んだか、実際はどうだったか。この4点セットを蓄積し、それを教材にオープンモデルを追加学習させています。使われたのはNemotron 3.5 Lightningで、総パラメータ30B、1回の推論で実際に動くのは約3Bという構成です。個人情報の除去に NeMo Anonymizer、例の偏りをならす合成データ生成に NeMo Data Designer、学習に NeMo AutoModel の LoRA を使い、学習はB200を2枚で数分だったとされています。
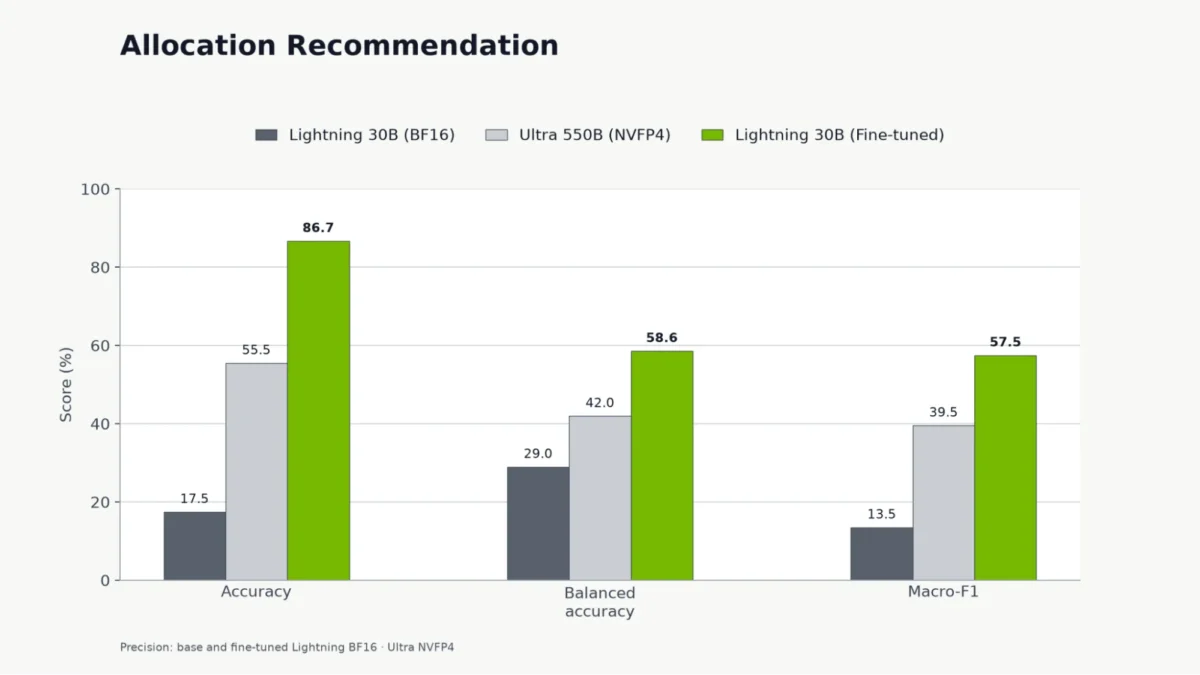
結果として、開発用ベンチマークでの割当判断の正答率は追加学習版が86.7%、はるかに大きい Nemotron 3 Ultra が55.5%、追加学習前の Lightning が17.5%でした。Ultra との差は31.2ポイント、自分のベースモデルとの差は69.2ポイントです。判断の種類ごとに等しく重み付けする指標でも、バランス精度58.6%対42.0%、Macro-F1が57.5%対39.5%と差がつきました。供給が絞られている局面では割当を減らす判断が多数派になるため、単純な正答率だけでは多数派を選び続けるモデルが有利に見えてしまう、という但し書きも添えられています。小型モデルを実務タスクに寄せる考え方はNemotron 3.5 Lightning の性能面やIBMの小型需要予測モデルでも同じ方向を向いています。
ただし NVIDIA 自身が、将来の生産リスク予測は追加学習後も難しいままだったと明記しています。伸びたのは学習させた判断タスクに限られ、付随する予測問題まで解けたわけではありません。
日本のEC事業者が明日から手を付けられる3つの論点
第一に、判断ログを残すところから始める価値があります。売上や在庫の数字は楽天RMS、Amazonセラーセントラル、Shopifyの管理画面から取れますが、「なぜその発注量にしたか」はバイヤーの頭の中にしかありません。発注量、その理由、見込んだ消化率、実際の消化率という4項目を、スプレッドシート1枚でよいので記録し始めるだけで、後から学習に使える資産になります。楽天市場の場合は店舗ページやR-Mailから外部サイトへ誘導しない前提で、モール内で完結する運用として設計できます。年末商戦の在庫判断についてはQ4の多販路在庫の考え方も参考になります。
第二に、モデルは大きさより絞り込みで選ぶという視点です。86.7%対55.5%という差は、汎用の巨大モデルより、自社の判断ログで鍛えた小型モデルのほうが特定タスクで上回りうることを示しています。EC事業者が最初に狙うなら、全社共通のAIではなく「季節商品の発注量レンジを提案させる」「滞留在庫の値下げ幅を提案させる」といった1タスクへの絞り込みが現実的です。在庫を仮想的に再現して試す発想はTargetの在庫デジタルツインの事例が近い形です。
第三に、決定権を人に残し、データは自社の内側に置く設計です。NVIDIAの構成でも推奨を出すのはモデル、最終的に決めるのはプランナーです。そして承認、修正、却下という人の反応そのものが次の学習データになります。オープンモデルを自社の計算環境で追加学習できるため、仕入原価や取引条件を外部に出さずに回せる点も、取引先との守秘義務を抱えるEC事業者には重要です。人とAIの役割分担については物流領域での判断軸の整理も合わせて確認してください。
なお、今回のスタックの日本国内での提供形態、Foundry の日本語サポート範囲、導入費用については発表資料に記載がないため要確認です。中小のEC事業者が同じ構成をそのまま組むのは現実的ではありません。真似すべきは道具立てではなく、判断を記録して学習できる形にしておくという段取りのほうです。
まとめ
NVIDIA と Palantir の事例が示したのは、熟練者の判断は属人的なままでは消えるが、根拠と結果をセットで記録すれば学習可能な資産になる、という一点です。そして特定の判断タスクに絞れば、30B規模のモデルが桁違いに大きい汎用モデルを上回りました。EC事業者がまず着手すべきは、AIの導入そのものではなく、来週の発注判断をなぜそうしたのかを書き残すことです。
参考文献
- NVIDIA Newsroom: NVIDIA and Palantir Bring Sovereign Intelligence to Critical Supply Chains
- NVIDIA Technical Blog: From Wafer-Out to First Token
- Palantir Foundry 公式
- NVIDIA cuOpt 公式
- Palantir Sovereign AI Operating System Reference Architecture
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: NVIDIA Newsroom
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます