 投稿者 投稿日: カテゴリー AIニュース

Tencent が、考えながら話し続ける全二重AI「Gander」を公開しました。
Tencent の Hunyuan Speech Team が、音声と映像を受け取りながら同時に話せる対話モデル「Gander」を公開しました。パラメータ数は9B(90億)と小型ながら、100シナリオの全二重ベンチマークで発話開始タイミングの正確さが最上位という結果が出ています。EC事業者にとって重要なのは、裏で時間のかかる処理を走らせている間も会話が途切れない設計が採られている点です。本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。
Gander とは何か、何が公開されたか
Gander とは、音声・映像・テキストの入力を受け取り続けながらリアルタイムに応答し、同時に複数ステップの作業も実行する対話エージェントモデルのことです。技術レポートは arXiv に2026年9月8日付で公開され、モデル本体とコード、学習データもあわせて公開されています。開発は Tencent の Hunyuan Speech Team を中心に、浙江大学、上海交通大学、香港中文大学、南洋理工大学の研究者が参加した共同体制です。
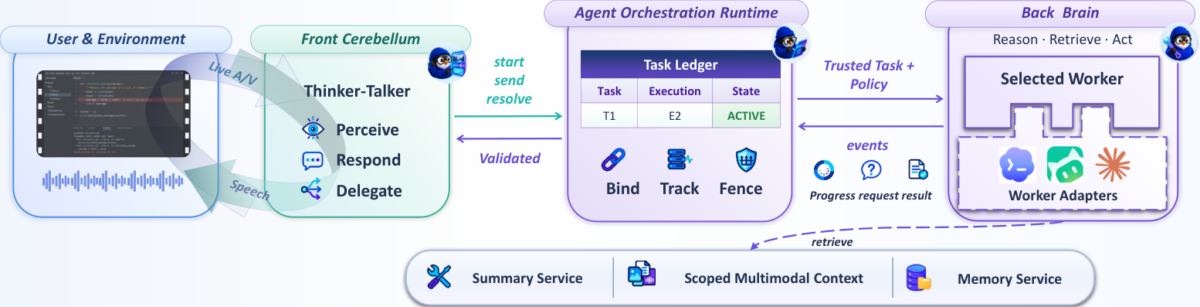
技術的な核は二つあります。ひとつは「小脳(Cerebellum)と大脳(Brain)」に役割を分ける構成です。小脳側がリアルタイムの知覚と会話を担当し、時間のかかる推論や計画は大脳側にツール呼び出しの形で委譲します。大脳は途中経過や計画を小脳に返せるため、処理中でも会話を続けられます。レポートによれば大脳は追加学習が不要な差し替え可能部品として設計されており、より強い推論モデルに置き換えるだけで全体の性能を引き上げられるとされています。
もうひとつは、入力と出力を時間軸で細かく区切り、ひとつの並びとして扱う流し込み型の構成です。モデルは区切りごとに「聞くか、話すか」を自分で予測します。従来のように外部の音声区間検出で発話の切れ目を判定するのではなく、話す判断そのものをモデルの内部に持たせた点が特徴です。
ベンチマーク結果は「話し出す間合い」に偏って強い
数字を見ると、Gander の強みと弱みははっきり分かれます。Full-Duplex-Bench v3(100シナリオ)で、Gander は100シナリオすべてで適切なタイミングで発話を開始しました。相手が話し終わる前にかぶせてしまう割合は8.0%で、GPT-Realtime の13.5%、最も弱いベースラインの47.9%を下回っています。会話の間合いという、全二重アーキテクチャが本来勝つべき軸では明確に上位です。
一方、タスク精度では商用モデルに届いていません。一度で正解にたどり着く Pass@1 は0.400で、GPT-Realtime の0.600に対して差があります。ツール選択は0.759、引数の正確さは0.503です。ただし、テキスト駆動で大脳側だけを動かした条件ではツール選択が0.934まで上がっており、精度の制約が推論側ではなく、リアルタイム対話を担う小脳側にあることが読み取れます。
もうひとつ見落とせないのが、発話権を取ってから実際の回答が出るまでの「つなぎ」の比率が51.6%と高い点です。裏で処理が走っている間に黙り込まない設計である以上これは想定内の挙動とレポートは説明していますが、裏を返せば「えーと」に相当する間が半分を占めるということです。音声理解の総合指標では SpokenQA が75.60と59.30、映像と音声を組み合わせた WorldSense が49.62、Daily-Omni が78.53という水準でした。
日本のEC事業者にとっての3つの論点
第一に、電話とチャットの一次受けです。楽天市場やAmazon、Yahoo!ショッピングの運営では、在庫の引き当てや配送状況の照会、注文履歴の確認といった処理に数秒から十数秒かかります。従来の音声ボットはこの待ち時間で沈黙し、顧客が話しかけて会話が壊れることが少なくありません。Gander が示した構成は、照会を裏に投げながら会話を続けるという、この現場課題に正面から対応するものです。すぐに導入できる完成品ではありませんが、音声応対ツールを選ぶ際の評価軸として「待ち時間中に会話が継続するか」を加える意味は大きいと考えます。
第二に、評価指標の置き方です。今回の結果は、応答の賢さと間合いの自然さが別々の軸であることを数字で示しました。自社でAI接客を検証するなら、回答内容の正確さだけでなく、割り込みへの追従、沈黙の長さ、かぶせの発生率を分けて測るべきです。日本語の接客は相づちが多く、間合いの設計が体験を大きく左右します。海外モデルの日本語での挙動は別途検証が必要な点は要確認としておきます。
第三に、ライブコマースや接客の配信現場です。映像と音声を同時に受け取れる構成は、画面に映っている商品を前提にした受け答えを可能にします。レポートでも、視覚情報から指示語の指す対象を特定する挙動が確認されたと記されています。コメント対応の補助や商品説明の自動生成といった使い道は、技術の成熟を待って検討する価値があります。
初動として何をすべきか
いま自社で取り組むべきことは限られています。まず、現在使っている音声・チャット応対ツールについて、外部システム照会時の待ち時間の実測値を取ることです。次に、その待ち時間に顧客が離脱している割合を問い合わせログから拾うことです。この二つの数字がないと、全二重型の技術が自社にとって意味があるかを判断できません。
そのうえで、モデル本体が公開されている以上、日本語での検証は自社でも技術的には可能です。ただし9Bとはいえ映像と音声を常時処理する構成であり、運用コストの見積もりは慎重に行う必要があります。中小規模の事業者であれば、まずは商用の音声応対サービスが同様の全二重方式を採用するのを待ち、比較検討に入るのが現実的だと考えます。
まとめ
Gander は、話す判断そのものをモデルに内蔵し、裏の処理中も会話を止めない構成を9Bという小型モデルで実証しました。タスク精度は商用モデルに及びませんが、間合いの自然さでは上回っています。日本のEC事業者としては、AI接客ツールの評価軸に「待ち時間中の会話継続」を加え、自社の待ち時間と離脱率を先に測っておくことが、次の選定で効いてきます。
参考文献
- Omni Interaction Agent Technical Report(arXiv:2609.08977)
- Gander 技術レポート HTML版
- Gander プロジェクトページ
- Gander コードリポジトリ(GitHub)
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: arXiv
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます