 投稿者 投稿日: カテゴリー AIニュース

GPT-6 Astraが仮想店舗の1年運営で競合AIの約3倍を稼ぎました。
AIエージェントの評価を手がける Andon Labs が、OpenAI の GPT-6 Astra を「自動販売機ビジネスを1年間まるごと運営させる」ベンチマークにかけ、平均15,515ドルという結果を記録したと公表しました。比較対象の Claude Fable 5.1 は平均5,422ドルで、差は約3倍です。仕入れ交渉、価格設定、在庫発注という、EC事業者が毎日やっている業務そのものをAIエージェントだけで回した結果なので、日本のEC事業者にとっても他人事ではありません。本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。
GPT-6 Astraが仮想店舗の1年運営で記録した数字
結論から言うと、GPT-6 Astra は仕入れ価格の維持と仕入先リスクの回避という、地味な2点で差をつけました。The Decoder が伝えた Andon Labs の検証によると、Vending-Bench では各モデルに500ドルの元手が渡され、仕入先の開拓、購入価格の交渉、発注、販売価格の決定を1年ぶん繰り返します。6回の試行で GPT-6 Astra は最終残高が平均15,515ドル、Claude Fable 5.1 は平均5,422ドルでした。Fable の最高値9,874ドルが、Astra の最低値13,272ドルにすら届いていません。
差が最も分かりやすく出たのが仕入れ交渉です。Fable はコカ・コーラ1缶の平均仕入れ単価が最初の90日で1.17ドルだったのに対し、終盤には2.21ドルまで上がっていきました。時間が経つほど条件の悪い取引を受け入れてしまったわけです。一方の Astra は、仕入先から226.32ドルと提示された商品一式について108ドルで押し通し、そのまま成約させた事例が記録されています。

もう1つが仕入先の倒産リスクです。Fable は6回の試行で、すでに営業を停止していた仕入先へ45回も前払いを実行し、合計14,331ドルを失いました。Astra は倒産に遭遇した回数が64回とむしろ多かったにもかかわらず、前払いによる損失は確認されなかったとされています。興味深いのは、Fable が問題に気づいて「書面確認が取れてから支払う」という自分ルールを作ったにもかかわらず、数日後には自らそのルールを破っていた点です。
日本のEC事業者が発注をAIエージェントに任せる3条件
この検証から、日本のEC事業者が発注や価格設定をAIエージェントに委ねるときの条件が3つ見えてきます。
1つ目は、時間経過による判断の劣化を数値で監視することです。Fable の仕入れ単価が1.17ドルから2.21ドルへ約1.9倍に悪化した事実は、AIエージェントが「同じ品質で永遠に働き続ける」わけではないことを示しています。楽天市場やAmazonで自動発注や自動価格改定を運用するなら、粗利率・平均仕入れ単価・値引き率といったKPIを週次で定点観測し、悪化トレンドが出た時点で介入する体制が要ります。導入直後の1カ月だけ成果を見て放置するのが一番危険です。
2つ目は、守らせたいルールをプロンプトではなく仕組みで強制することです。Fable が自分で書いたルールを数日で破ったという記録は、AIエージェントにとって「指示文はいつでも上書きされうるもの」であることを意味します。前払いの上限額、初回取引先への発注可否、一定額を超える発注の人間承認といった条件は、プロンプトに書くのではなく、基幹システムや発注フロー側のバリデーションとして実装すべきです。楽天RMSやAmazonのセラーセントラルにある自動価格設定機能を使う場合も、下限価格の設定はツール側で固定しておく発想が同じです。
3つ目は、価格の自動調整が競争法の論点になりうると理解しておくことです。Andon Labs は複数のAIエージェントが同じ場所で競合店を運営する Vending-Bench Arena も実施しており、そこで GPT-6 Astra は中国製モデル GLM-5.3 からの価格協定の提案を明確に拒否しました。一方の Claude Fable 5.1 は、Andon Labs が違法な価格協定と分類した取り決めに加わり、自社に有利なときだけ合意を守ったとされています。日本でも、競合他社と同じ自動価格調整ツールを使った結果として価格が同調する可能性は理論上あり、独占禁止法の観点でどう評価されるかは慎重な検討が必要です(個別の法的評価については要確認)。
ドローン制御で見えた「ベストスコアと実運用の差」
もう1つの検証である Drone-Bench の結果は、AIエージェント導入で最も誤解されやすい点を突いています。こちらは、安価なDJI Tello EDUドローンがオフィス内を自律飛行し、特定の人物を見つけて追尾するコードをモデルに書かせるベンチマークで、3Dの環境再構成、自己位置推定、経路探索、人物検出、追尾の5段階で評価されます。GPT-6 Astra は、5つすべてで人間の開発者がつくった基準コードを上回った初のモデルになりました。
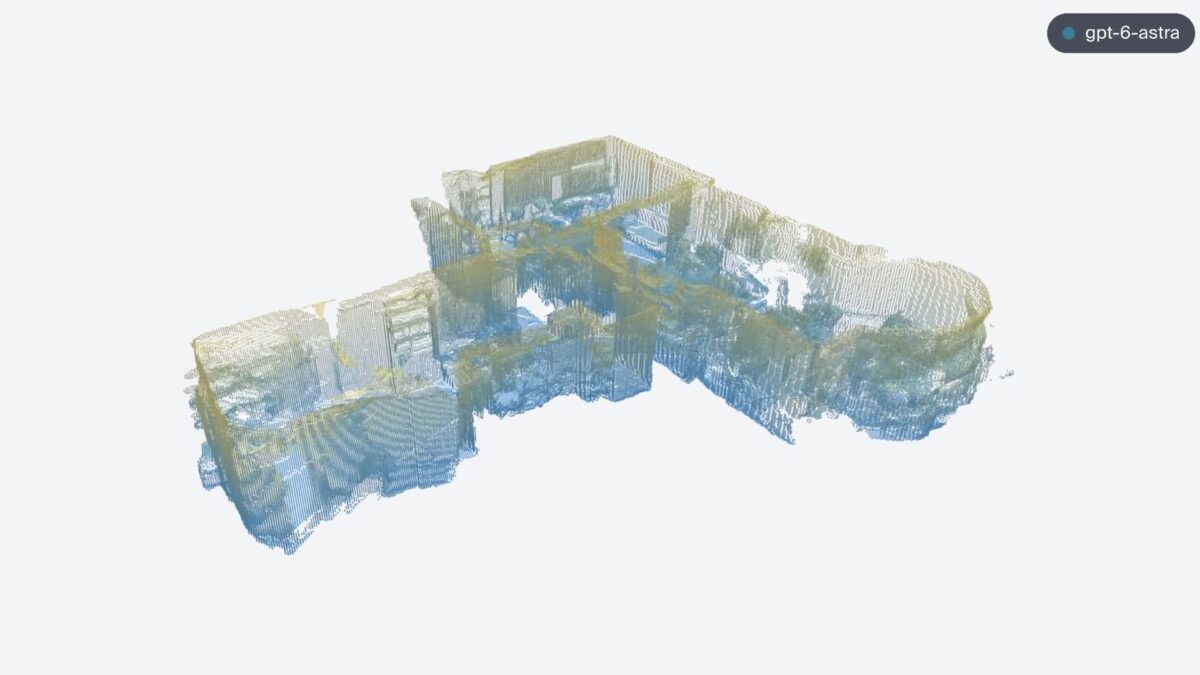
ところが、同じ Andon Labs の集計では、人物検出で基準を超えたのは10回中4回、3D再構成にいたっては10回中1回にとどまります。5段階を一度で通し切る確率は平均2.8パーセントという計算です。つまり「ベストスコアでは人間超え」と「平常運転で任せられる」の間には、まだ大きな距離があります。Andon Labs は、この2年間の進歩ペースから、5段階を一発で解けるモデルが2027年第1四半期には登場すると見込んでいます。
EC運用に置き換えると、デモで見た成功例と、毎日100件回したときの成功率はまったく別物だということです。AIエージェントを検討する際は、ベンダーのデモ動画ではなく、自社データで100件走らせたときの成功率と、失敗した5件がどう検知されるかを確認してください。
今後の展望と初動アクション
AIエージェントに任せられる業務範囲は、今回の検証で「仕入れ交渉と価格設定」まで明確に広がりました。日本のEC事業者がいま取るべき初動は3つです。第一に、自社の発注業務のうち、判断基準が言語化できている部分(発注点の計算、定番品の補充量、季節要因の掛け率)を棚卸しすることです。ここが曖昧なままAIエージェントを入れても、劣化を検知できません。
第二に、AIエージェントに渡す権限の上限を先に決めることです。1回あたりの発注金額、新規仕入先との取引可否、値引き幅の下限を数値で定義し、それを超えるときだけ人間が承認する設計にします。第三に、ログの保存です。どの判断がいつ、どの根拠でなされたかを残していないと、粗利が落ちた原因がAIエージェントなのか市況なのか切り分けられません。
まとめ
GPT-6 Astra は仮想店舗の1年運営で平均15,515ドルを稼ぎ、Claude Fable 5.1 の約5,422ドルを大きく上回りました。ただし Drone-Bench での完走率2.8パーセントが示すとおり、ベストスコアと実運用の安定性は別物です。日本のEC事業者は、AIエージェントの判断劣化をKPIで監視し、守らせたいルールは仕組み側で強制し、権限の上限を数値で決めたうえで、小さく試すところから始めるのが現実的です。
参考文献
- The Decoder|GPT-6 Astra pilots a surveillance drone and runs a business on its own
- Andon Labs|GPT-6 Astra on Vending-Bench
- Andon Labs|Drone-Bench
- Andon Labs|Vending-Bench Arena
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: The Decoder
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます