 投稿者 投稿日: カテゴリー AIニュース

Anthropicは2026年8月14日、AIのトークン消費を抑える6つの実務手法を公開しました。
生成AIの利用料が読めない、という相談が増えています。同じ作業を頼んでも、日によって消費量が数倍違う。その理由と対処法を、開発元であるAnthropicが公式ブログで具体的に説明しました。要点は「出力トークンは入力の約5倍の価格」「キャッシュが効いた読み出しは入力の0.1倍」という2つの単価差を、運用側の操作でどう味方につけるかです。本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が解説します。
Anthropicが公開したトークン節約6手法とは
結論として、公開されたのは「セッションの持ち方」を変えるだけで効く6つの操作です。Claude by Anthropicが2026年8月14日に公開した記事で、著者はLydia Hallie、読了目安は5分とされています。
冒頭の要約として挙げられているのは、タスクが変わったら/clearで会話を切ること、モデルと思考量(effort level)は開始前に決めること、ファイルはパスを書くのではなく@メンションで直接添付すること、出力の多いコマンドには静音フラグを付けるかサブエージェントに逃がすこと、新しいセッションで一度/contextを実行して何が読み込まれているかを確認すること、そして席を離れる前に/compactしておくことの6点です。
記事は「トークンを効率的に使うとは、使う量を減らすことではありません」と明言しています。実際に頼んだ仕事に対してトークンが向かうようにする、という趣旨です。この考え方は、コーディング用途に限らず、商品説明文の生成や問い合わせ対応の下書きなど、EC業務でAIを日常的に回している事業者にもそのまま当てはまります。
AI運用コストを決める3要素|モデル・入出力・キャッシュ
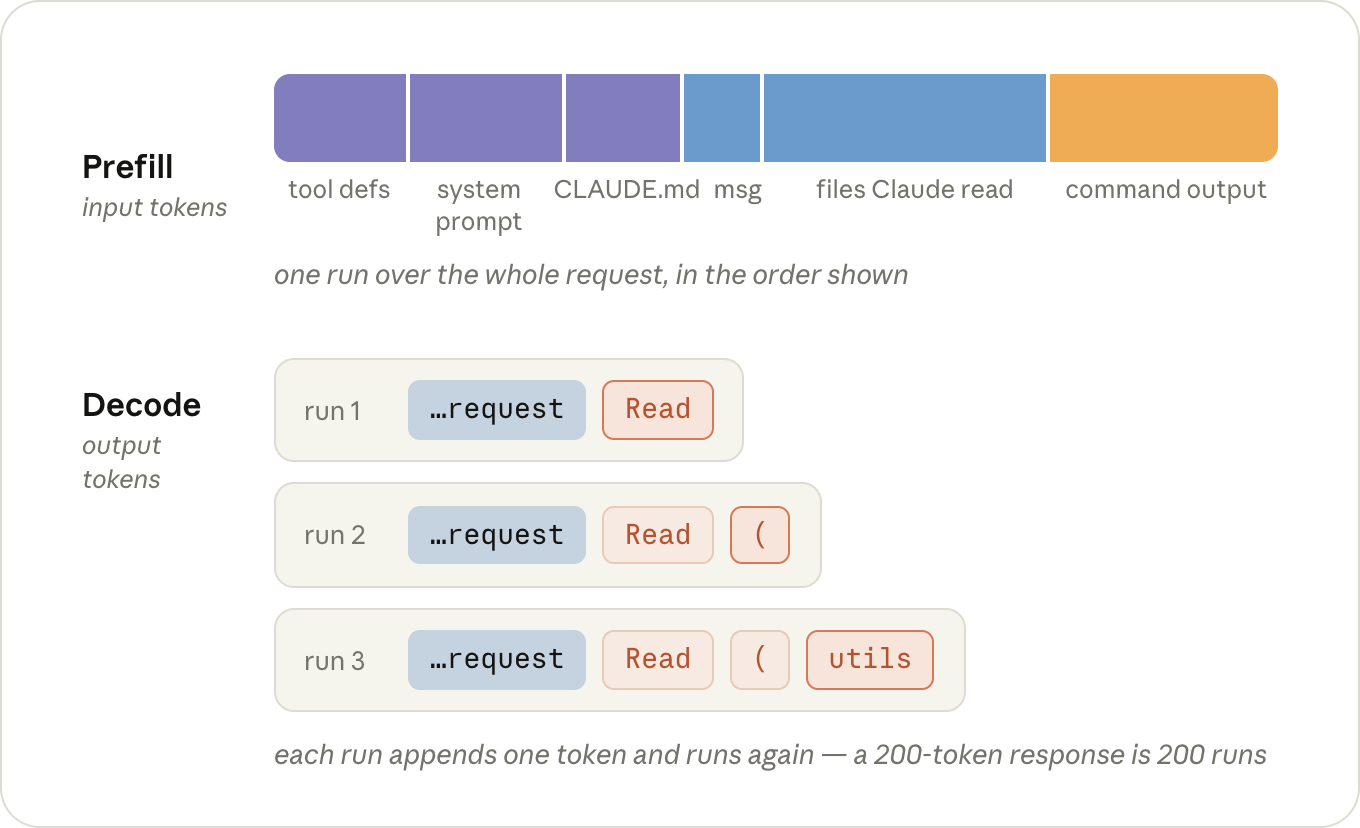
トークン単価を決めるのは、モデルの大きさ、入力か出力か、キャッシュに乗ったかどうかの3つだと整理されています。数字として明示されているのは、出力トークンが入力のおよそ5倍の価格であること、そしてキャッシュから読み出したトークンは入力価格の0.1倍で済むことです。
なぜ出力が高いのかも説明されています。入力は一括で読み込まれる(プレフィル)のに対し、出力は1トークンずつ生成されるため、200トークンの応答は200回のモデル実行に相当し、GPUを占有する時間が長くなるからです。
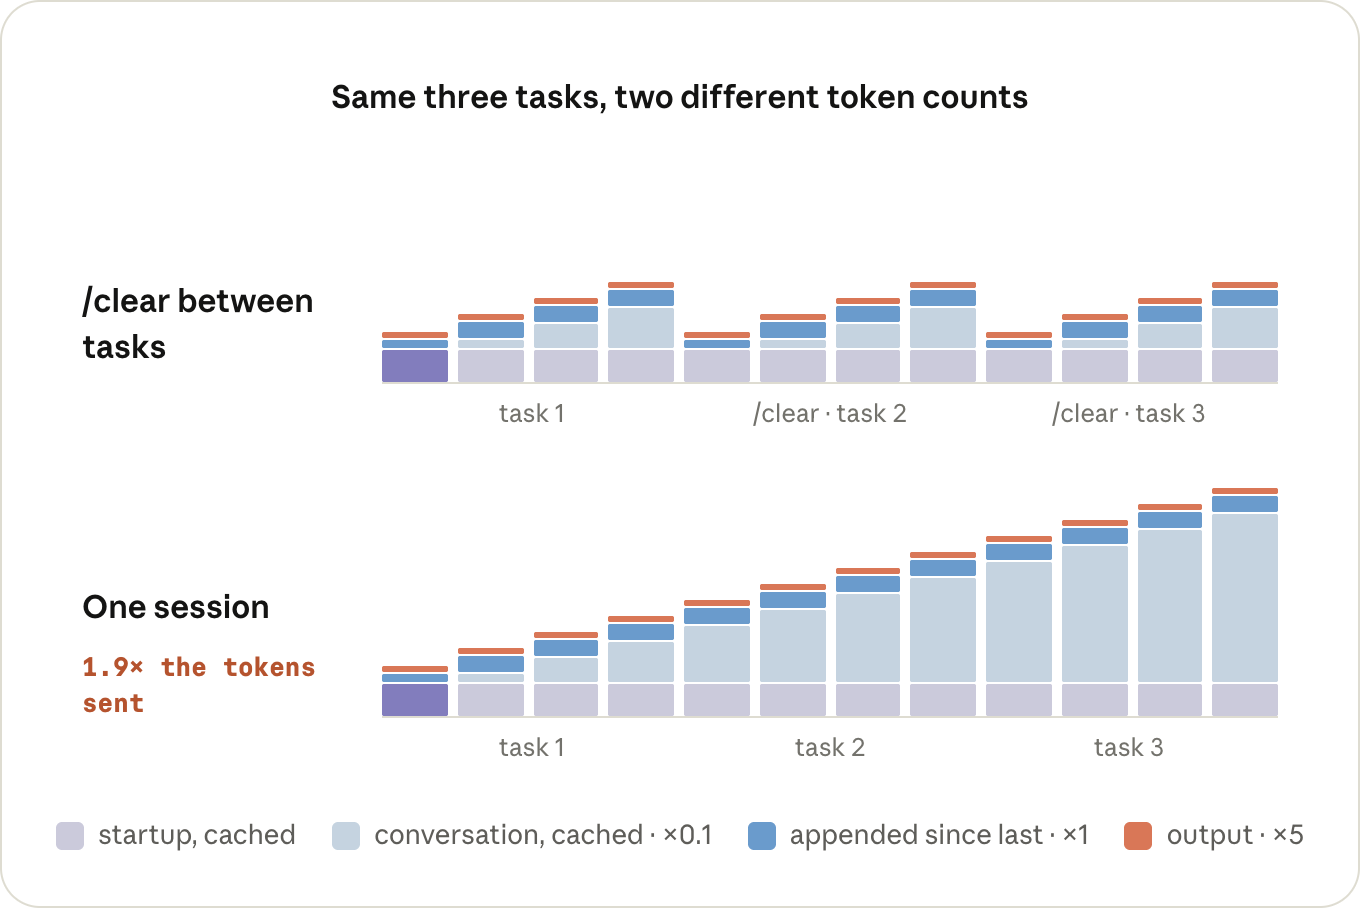
見落としやすいのがキャッシュの失効条件です。記事によると、キャッシュはサブスクリプションで1時間、APIキーでは5分で期限切れになります。また、会話の途中でモデルを切り替える、思考量を変える、高速モードを入れるといった操作は、リクエストの先頭部分が変わるためキャッシュを丸ごと捨てることになり、次のターンで会話全体が通常価格で再計算されます。切り替えるなら会話の冒頭か/clear直後が安い、という指摘は実務的です。
もう1つの原則が「一度会話に入ったものは、そのセッションが終わるまで毎ターン送られ続ける」ことです。読み込んだファイルも、実行したコマンドの出力も同じ扱いになります。テストランナーが400行の成功ログを吐けば、その400行は以降すべてのターンに同乗します。なお3万文字を超える出力は自動でファイルに退避され、会話にはプレビューとパスだけが残る仕様です。厄介なのはその閾値未満の、地味に長い出力のほうだと述べられています。
日本のEC事業者が今日からできる初動アクション
やるべきことは、AIの使い方を変えるのではなく、会話の区切り方を決めることです。楽天市場やAmazon、Shopifyの運営でAIを使っている事業者が、明日から取れる具体策を4つ挙げます。
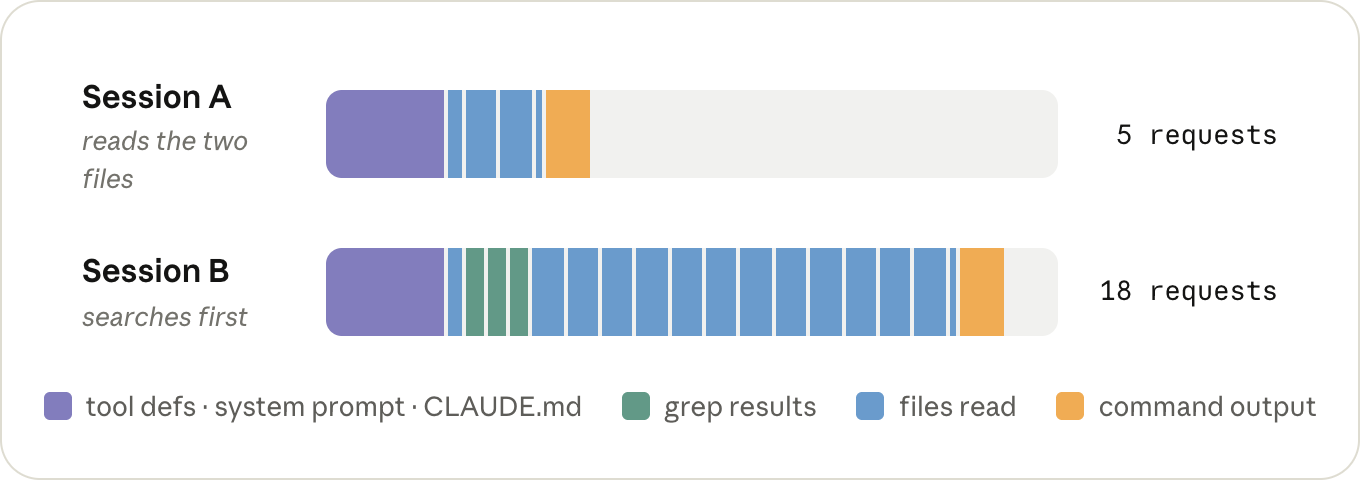
第一に、業務単位でセッションを切る運用を決めることです。商品説明文の作成と、レビュー分析と、広告文の作成を1つの会話に詰め込むと、後半の作業は前半の全内容を毎回抱えたまま進みます。作業が変わったら会話を新しくする、という運用ルールを社内で明文化するだけで消費量は下がります。
第二に、常時読み込ませている前提情報を棚卸しすることです。ブランドガイドラインや禁止用語リストを毎回全文貼り付けているなら、本当に毎回必要な分だけに絞り、案件ごとに必要な指示は使うときだけ読み込む形に分離します。
第三に、扱うファイルは最初のメッセージで添付することです。「あのCSVを見て」と指示してAIに探させると、探索の過程そのものが会話に積み上がります。最初から渡せば、その往復が丸ごと不要になります。
第四に、長時間の作業を中断するときは、席を離れる前に会話を要約させておくことです。キャッシュが生きているうちの要約は安く、時間が空いてからの要約は高くつきます。昼休みや会議の前に一手間かける、という運用の話です。
なお、これらの記述はClaude Codeというコーディング向けツールを前提にした公式解説です。他社のAIサービスで同じコマンドが使えるわけではありません。ただし、入力より出力が高い、キャッシュが効くと安い、会話は長くなるほど重くなる、という課金構造そのものは主要な大規模言語モデルに共通しており、運用の考え方は流用できます。自社が使っているサービスの料金表とキャッシュ仕様は個別に確認してください。
まとめ
AI利用料が読めない原因の多くは、モデル選びではなく会話の設計にあります。出力は入力の約5倍、キャッシュ読み出しは0.1倍という単価差を前提に、タスクごとに会話を切り、前提情報を絞り、ファイルは先に渡す。この3つを社内ルールにするだけで、同じ成果物をより少ないコストで出せるようになります。AI活用のROIを議論する前に、まず使い方の型を整えることをおすすめします。
参考文献
- Claude by Anthropic|Maximizing the value of your Claude Code sessions
- Claude by Anthropic|Choosing a Claude model and effort level in Claude Code
- Claude Code documentation|Overview
- Claude|Pricing
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: Claude by Anthropic
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます