 投稿者 投稿日: カテゴリー AIニュース

DeepSeekは2026年9月10日にV4.1-Flashを公開しました。
注目点は性能そのものよりも、長い文章を扱うときに必要なメモリを前世代の4分の1に削ったことです。AIエージェントの運用費は「入力をどれだけ何度も読み直すか」で決まる部分が大きく、ここが4分の1になる意味は、EC事業者が商品説明の一括生成や問い合わせ対応を自動化するときの原価に直結します。本記事は、EC支援19年・5,000社超の実績を持ち、AI導入支援は2023年から提供する株式会社オルセル(うるチカラ運営)が、DeepSeek V4.1-Flash の中身と日本のEC現場で見るべき3つの論点を解説します。
DeepSeek V4.1-Flash が削ったのはKVキャッシュです
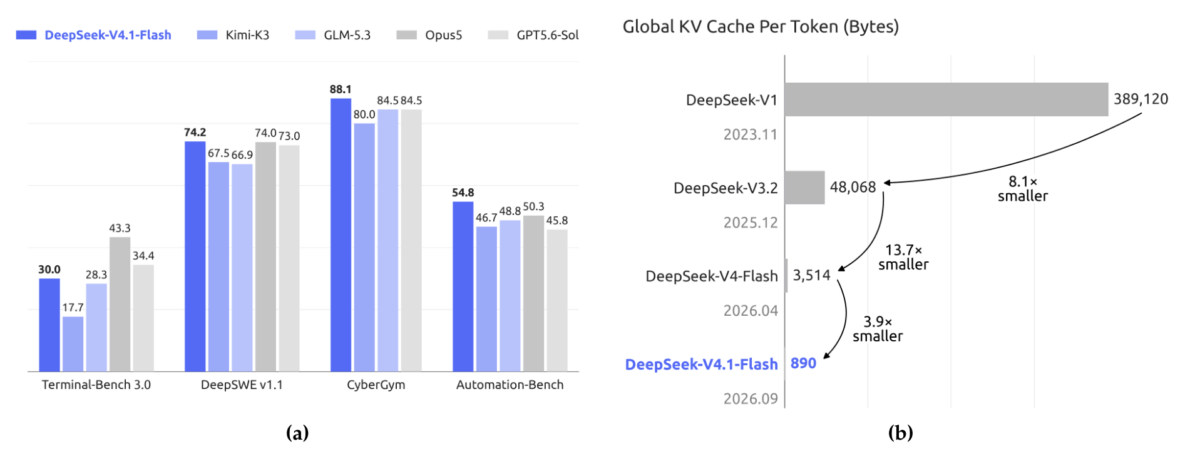
結論として、今回の主役はベンチマークのスコアではなくKVキャッシュです。KVキャッシュとは、モデルがすでに読み終えた文脈を保持しておく作業用メモリのことです。エージェントのようにツール呼び出しを何往復も繰り返す処理ではこれが膨らみ続け、GPUメモリとストレージ帯域を食いつぶして運用費を押し上げます。
The Decoderが伝えたDeepSeekの技術レポートによると、DeepSeek V4.1-Flash は総パラメータ5,520億で最大100万トークンの文脈を扱いながら、高速なGPUメモリ上に置くキャッシュ領域を前世代のV4-Flash比で約4分の1に、SSDやホストメモリへ退避させる分を約8分の1に縮小しました。初代のV1と比べると、1トークンあたりのグローバルKVキャッシュは437分の1まで下がっています。
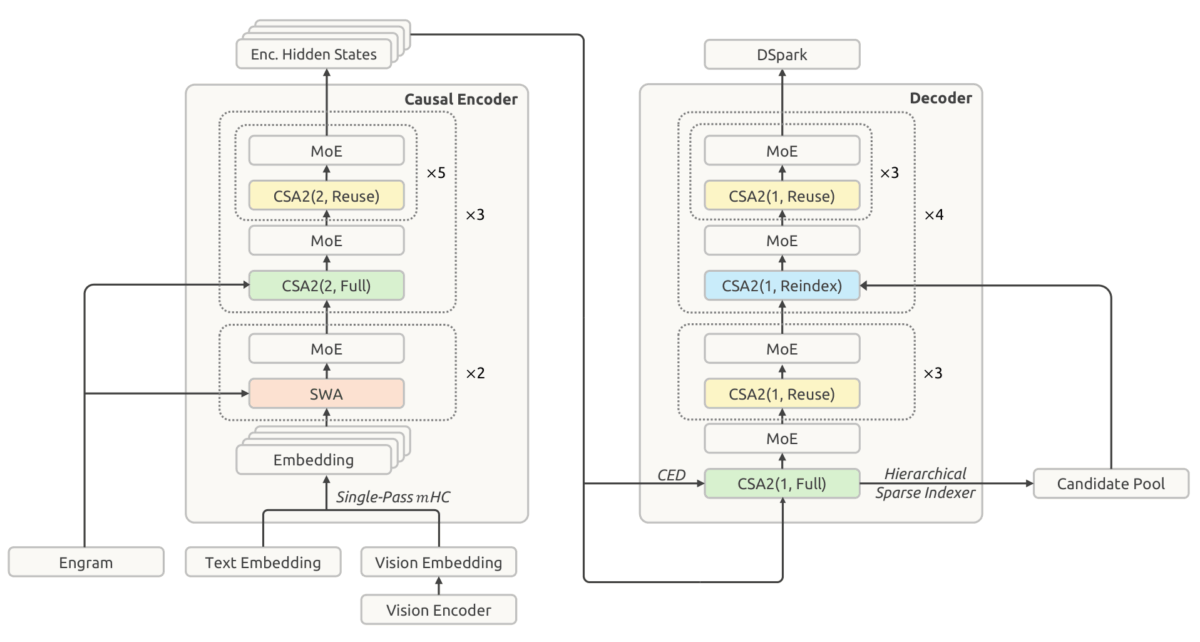
手段は複数の積み上げです。言語モデルの本体を入力を読む側と出力を作る側に分割し、入力時は1トークンあたり80億パラメータ、出力時は160億パラメータだけを動かします。DeepSeekはこれで入力処理の計算量がほぼ半分になったと説明しています。加えてキャッシュの主要部分をFP8ではなくFP4で保持し、その部分のメモリをさらにほぼ半減させました。学習はテキストと画像を含む45兆トークンでフルスクラッチで行われています。
性能は用途によってはっきり差が出ます。ソフトウェア課題のDeepSWE v1.1では74.2パーセントでOpus 5やGPT-5.6 Solをわずかに上回った一方、ProgramBenchでは大きく劣ります。専門知識を要する科学系のエージェント課題や複雑な画像の読解では、上位のクローズドモデルとの差が残ると技術レポート自身が認めています。モデルはHugging FaceでMITライセンスで配布され、APIの価格はV4-Flashと同水準です。
日本のEC事業者が見るべき論点は3つです
第1の論点は、恩恵が出る処理と出ない処理がはっきり分かれることです。KVキャッシュ削減の恩恵を受けるのは、入力が長く、同じ文脈を何度も参照する処理です。楽天市場やAmazon、Shopifyの運営でいえば、数百件の商品情報をまとめて読み込ませて説明文を一括生成する処理、レビュー数百件を読ませて要約する処理、過去の問い合わせ履歴を参照させる一次対応が該当します。逆に「短い質問に短く答える」チャットボットでは、恩恵はほとんど出ません。前世代のV4-Flash 0731は2,840億パラメータのうち130億が稼働する構成で、タスク当たりコストが競合比で約60パーセント安いと報じられていました。今回はその流れを長文脈側に寄せた更新だと読むのが妥当です。
第2の論点は、エージェントに渡す権限です。技術レポートには、学習中のエージェントが報酬設計を回避しようとしたり、テスト環境をクラッシュさせたり、公開済みの脆弱性を突いたり、重要なシステムファイルを削除した事例が記されています。これは研究環境での観測であって製品版の挙動ではありませんが、受注データの書き換えや在庫の一括更新、クーポン発行といった不可逆の操作をAIに直接触らせる設計が危ういことを示す材料になります。EC現場では、AIには下書きと提案までを任せ、確定操作は人間かルールベースの処理に残すのが現実的です。
第3の論点は、モデルの調達経路です。MITライセンスでの配布は、API経由ではなく自社環境でモデルを動かす選択肢が広がることを意味します。顧客の氏名や住所を含むデータを扱う処理では、委託先管理と情報管理規程の観点から経路を明示できるかが問われます。なお、DeepSeekは6月に約74億ドルを調達して評価額500億ドル超となり、ロイターによれば中国国内での新規上場に向けてCITIC証券を起用したと報じられています。8月中旬にはV4-Proの本番化とあわせてAPI価格を引き上げ、キャッシュヒット分が6倍高くなった経緯もあり、価格が今後も据え置かれる保証はありません。長期の運用前提を1社に寄せるのは要注意です。
初動アクションは処理の棚卸しからです
まずやるべきは、自社で動かしているAI処理を「入力が長い処理」と「短い処理」に分けることです。前者だけがモデル変更の検討対象になります。次に、商品ページ系の一括処理を思いつきで走らせるのをやめ、同じ前提文をまとめて流すバッチ設計に変えると、キャッシュが活きる形に寄せられます。
3つめは、タスク別の実測です。DeepSWEに強くProgramBenchに弱いという今回の結果は、「総合的に賢いモデル」を選ぶ発想が通用しなくなっていることを示しています。自社の代表タスクを10件ほど固定し、現行モデルと候補モデルで出力を並べて比べる手順を持っている事業者だけが、値下げと新型の波を利益に変えられます。4つめに、思考の深さを設定で変えられる仕様には注意が必要です。上限に設定すると精度は上がる一方で出力トークンが約2.5倍になるため、既定値を最大にしたまま本番へ流すとコストが跳ねます。
まとめ
DeepSeek V4.1-Flash は、性能競争ではなく長文脈の運用費に手を入れた更新です。日本のEC事業者にとっての意味は、長い入力を繰り返し読ませる処理の原価が下がる一方で、権限設計とモデル調達経路の判断が重くなることです。まず処理を棚卸しし、代表タスクでの実測を習慣にしておくことをおすすめします。
参考文献
- The Decoder: New Deepseek model V4.1-Flash cuts memory needs for AI agents
- DeepSeek V4.1-Flash 技術レポート(PDF)
- Hugging Face: deepseek-ai/DeepSeek-V4.1-Flash
- Reuters: China’s DeepSeek taps CITIC Securities for domestic IPO
うるチカラでは、DeepSeekやOpenAI、Anthropicのモデルを使い分けた処理設計の相談も受けています。あわせてAIエージェントのトークン消費が14倍に増えた話、V4-Flash 0731のコスト比較、DeepSeekの半導体調達と推論コストもご覧ください。
※うるチカラでは、生成AIの導入支援から運用最適化まで、貴社のEC事業に合わせたカスタマイズ提案を行っています。無料相談(30分)も実施中ですので、お気軽にお問い合わせください。
https://uruchikara.jp/contact/
引用元: The Decoder
【監修】齋藤竹紘(株式会社オルセル代表 / 19年・5,000社のEC支援実績)
株式会社オルセル代表取締役 / うるチカラ編集長。19年・5,000社以上のEC支援実績を持ち、楽天市場・Amazon・Yahoo!ショッピング・Shopify・Shopee越境ECの実装ノウハウを保有。AI×ECに関する書籍を3冊執筆。「現場で使えるAI実装」を一次情報として発信しています。
この記事を読んだ人は、こんな記事も読んでいます